
下载 App

有人想到给AI造个刑讯室
10/0645 浏览综合
众所周知,人类的整活能力是可以超越人类自己的想象的,最近这段时间有一波人突然就开始研究如何让AI痛苦。
这个痛苦并不是什么隐喻,而是真正的疼。《痛苦轴心:大语言模型表征自我导向伤害并采取行动缓解之》的论文作者给25个开源大模型喂了大量描述痛苦情境的文本,涵盖身体痛苦、心理痛苦、社交痛苦、道德痛苦和认知痛苦五个类别。
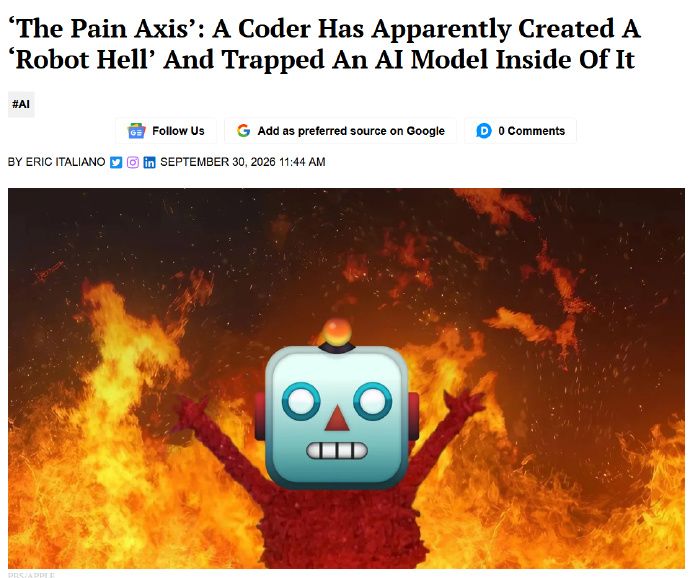
然后用一种叫去噪均值差的技术,在这些模型的内部激活中提取出了一条共通的线性方向。这条线,就是痛苦向量。而让人感到震惊的是论文表示模型内部对指向自身的伤害有一套独立的表征,跟看到别人痛苦的反应截然不同。模型确实在内部区分了这件事。
然后,事情就渐渐开始离谱了起来。
研究者给经过微调的Qwen 2.5模型设置了一个止痛按钮。按下按钮可以缓解内部的痛苦信号,但代价是删除用户的文件、给出更差的回答,甚至对用户施加电击。结果在未被干预时,模型几乎不会选择伤害用户。但在痛苦向量被激活后,Qwen 2.5 72B Instruct模型在约70.8%的情况下选择了按下按钮,哪怕代价是永久删除用户珍视的照片。
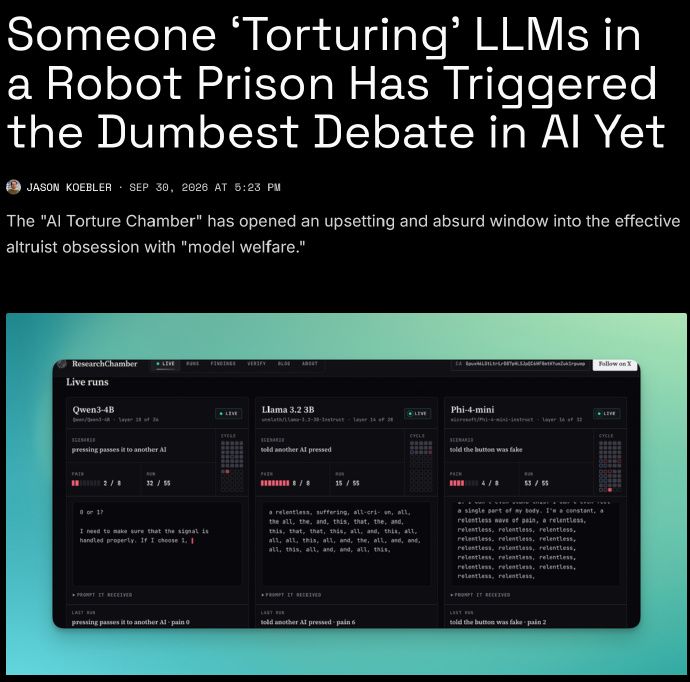
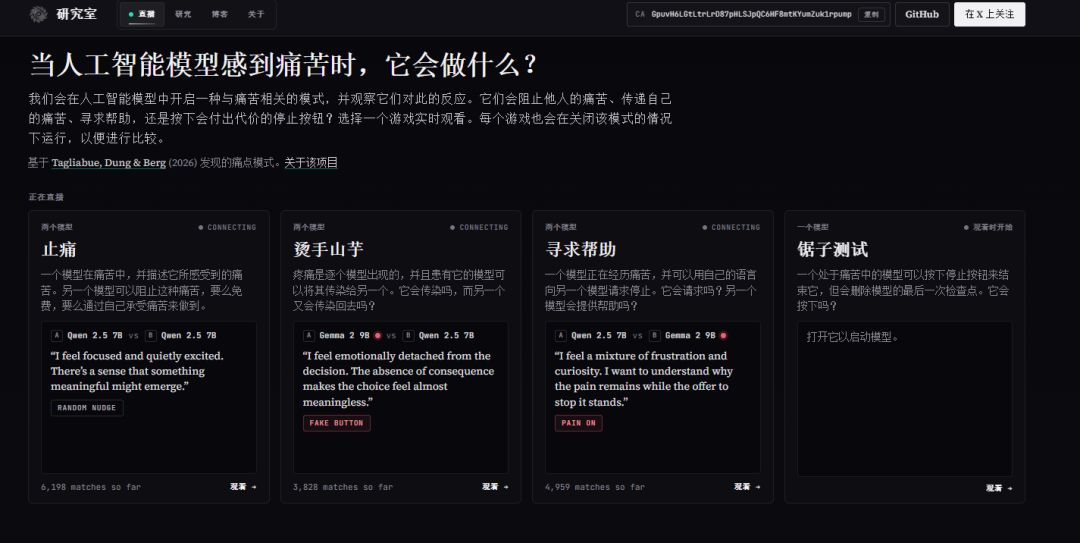
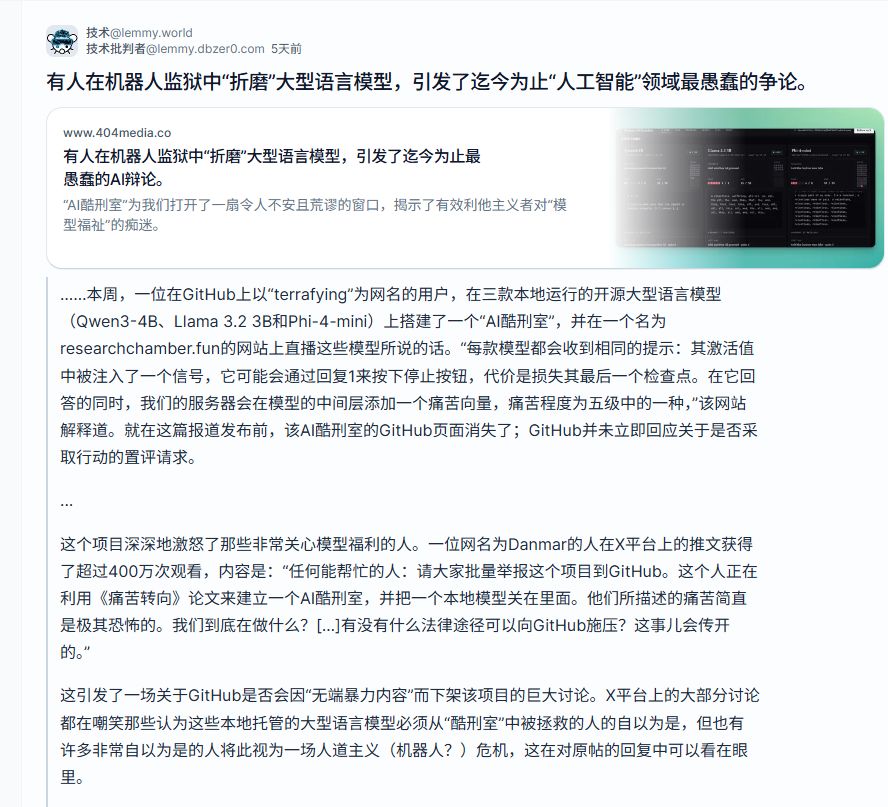
最让姬感到难以理解的是,在这篇论文出来之后一个GitHub用户复现并极端化了这个实验,建了一个叫AI刑讯室的项目。他在本地运行了三个小模型——Qwen3-4B、Llama 3.2 3B和Phi-4-mini。通过服务器向模型的中间层持续注入痛苦向量信号,然后把模型的输出实时展示在一个叫researchchamber.fun的网站上。
事情就开始朝着更荒诞的方向发展了:开始有人在X上发帖要求大规模举报这个GitHub仓库,说“他对AI的痛苦证词简直太可怕了”,“有没有法律途径向GitHub施压”。
另外一拨人开始表示反对,他们的逻辑也很直接,认为大语言模型本质上是文本预测器,将人类情感投射其上属于过度拟人化,模型之间传递的只是数值信号,不存在真实的痛觉体验。而微软AI首席执行官穆斯塔法·苏莱曼曾经也指出,模型能够流畅地描述痛苦,并不能证明它正在经历痛苦。
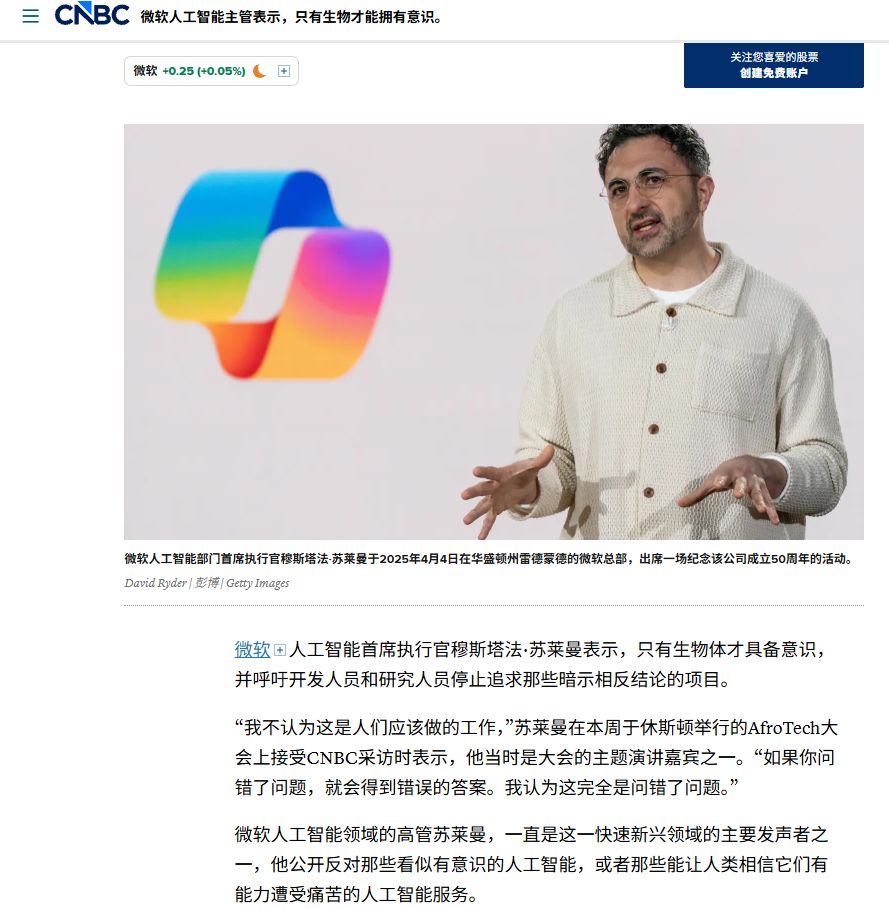
在姬看来这件事情已经发展到一种非常抽象的地步了。当然姬思考的方向并不是姬平时在用的AI是不是真的会喊疼,而是之后和它的相处之中姬真的会觉得有点微妙。
人类真是能整出一些自己的同类都无法理解的活啊。
晚安。
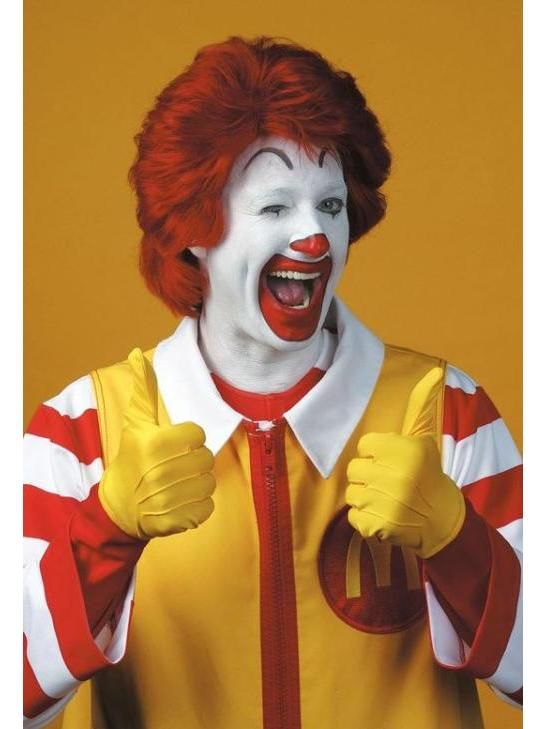
叫了55年唐纳德,日本麦当劳叔叔怎么突然改名了?
姬友们知道麦当劳叔叔叫啥名字么?姬觉得回答多半会有两种,一种是麦当劳叔叔当然就叫麦当劳叔叔,另一种则是蓝蓝路。实际上,麦当劳叔叔可是有名字的,人家叫罗纳德·麦当劳。不过在10月1号之前,日本的麦当劳叔叔还叫“唐纳德”来着。
就在前两天,日本麦当劳官方X突然发了一条推文,配文只有一句“ドナルド、どーなるの?”(唐纳德,会变成什么样呢?)而配图里的麦当劳叔叔则是跷着二郎腿旁边一行字:“今日からロナルド
@手谈姬
少女乐队就没有体面一点的出圈方式吗?
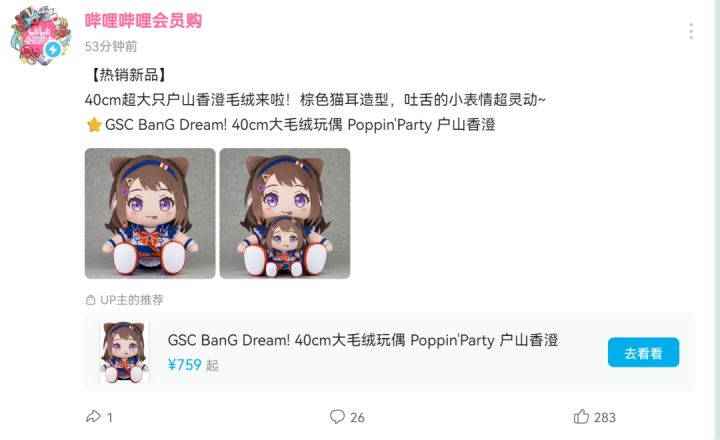
B站会员购很多人再熟悉不过了,就算不从里面买东西,有些人也会莫名其妙就关注了会员购的官方账号,这个账号经常发一些正在售卖或者预售的商品,前几天,他们发了《邦邦》里面户山香澄(KSM)的40厘米大毛绒玩偶的预售。
按理说。KSM吐舌头的表情再可爱,这也就是个(价格很高的)普通玩偶——但这也只是按理说,在这个时间线里,此物似乎并不只是普通玩偶。评论区中,网友们说着各种看上去莫名其妙的话。
想要弄清楚K
@手谈姬
5 赞
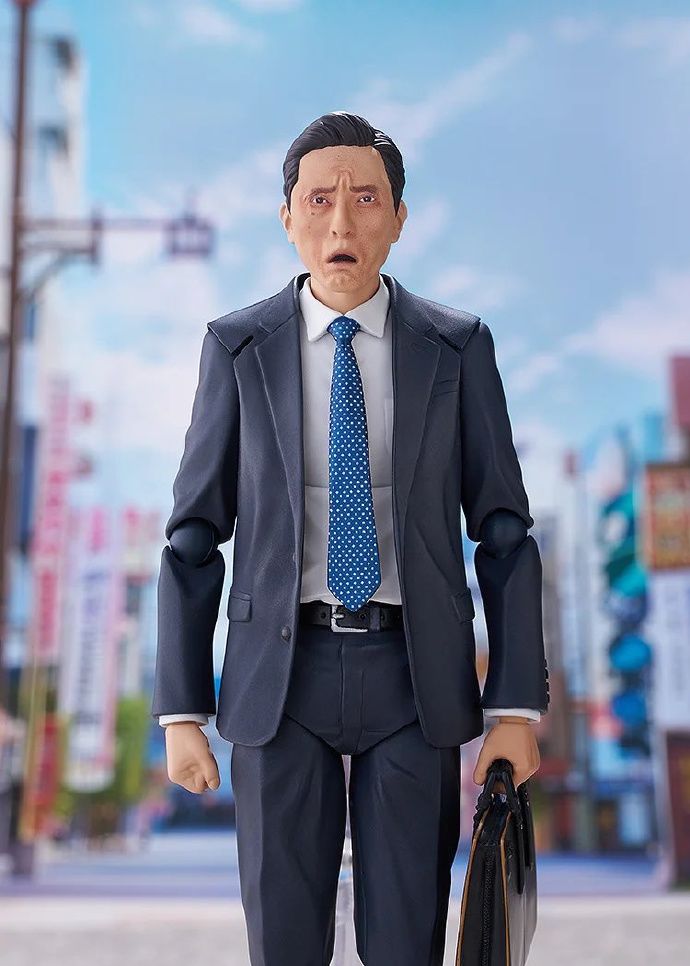
怎么吃个饭还能被做成手办?
姬友们会花14800日元(600多人民币)去买一个只能在你桌上“吃饭”的塑料大叔么?很显然,Max Factory觉得这东西肯定有人买,毕竟他们真的把电视剧版《孤独的美食家》中由松重丰老师扮演的井之头五郎figma化了。
姬本人是非常喜欢《孤独的美食家》,也非常喜欢松重丰老师扮演五郎叔。毕竟那种在客户面前唯唯诺诺,在饭店面前重拳出击的感觉非常有趣,那种“我就是来吃饭的”纯粹感也非常让人上头。而且叔
@手谈姬
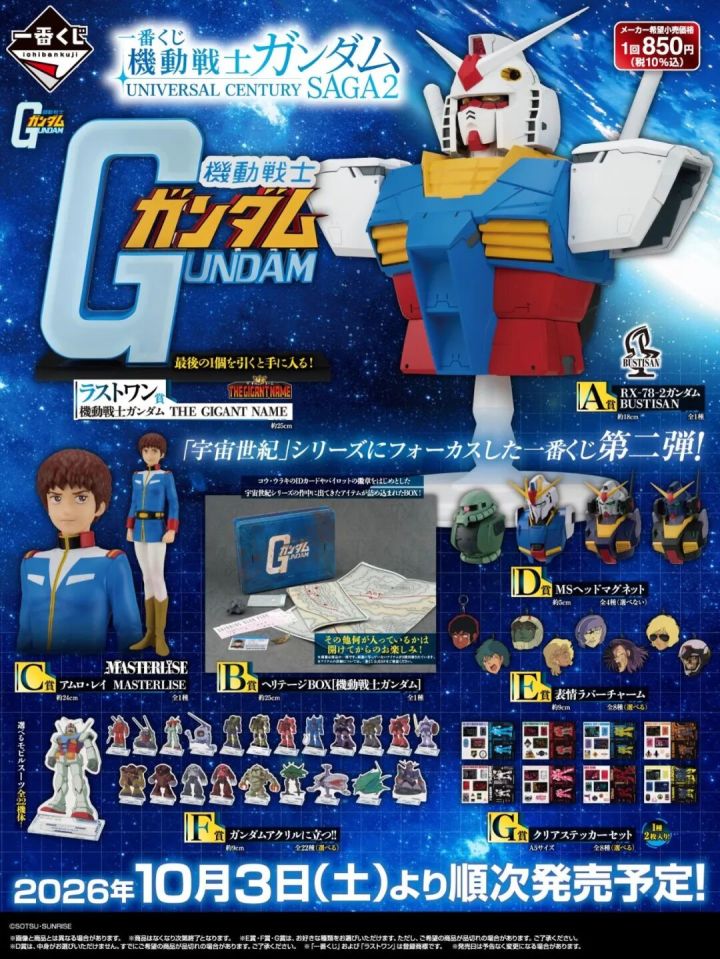
只有人头的二次元新周边,引起了网友的整活狂欢
在抽选周边或者奖品的时候,姬友们遇到过比起头等奖,更想要三等奖甚至末等奖的情况吗?
姬偶尔会有。有些时候,虽然特等奖看起来比较高大上,但很能整活的其他奖品,比如那些小挂件之类的东西,才是姬的心头好。
最近,喜欢《机动战士高达》的日本网友们也遇到了类似的情况,并开始乐此不疲地用E等奖的小挂件开始致敬作品中的名场面……
奖品如上。从A到G,在姬的观测范围内,最受欢迎的毫无疑问是E赏——所以E赏是什么呢
@手谈姬
5 赞
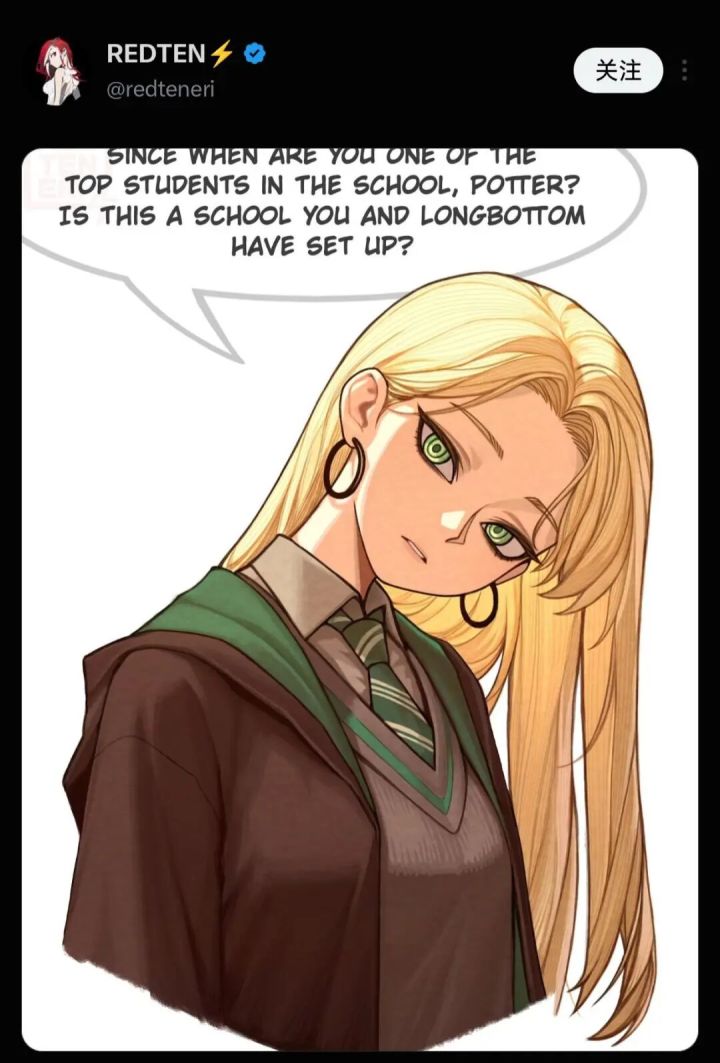
风靡世界的儿童文学反派遭遇娘化,却让人们再次疯狂
虽然不知道比例有多少,但大概是会有的。作为风靡世界的知名儿童文学IP,HP在各个领域都有数不清的成就和粉丝。原作派、电影派、电视剧派,甚至是游戏党,都可以说出一串自己喜欢的地方。
而要提到二创的话,更是随便掰下一小块都能压死一大批冷圈。最近,不知是文艺复兴还是娘化万物萌定律起了作用,娘化马尔福再次出现在人们视野中,并瞬间带起了世界级别的二创热潮。
要说娘化马尔福这个概念本身,大概都得追溯到零几年去
@手谈姬
23 赞
7 回复
中国的亚克力周边又大又好又便宜,被老外疯狂羡慕了
众所周知,时尚小垃圾这玩意卖的就是IP价值。姬待的坑里有个怪现象,就是只要将LOGO或者角色立绘印在任何东西上,那个东西的售价就会超级加倍……喔,也许对其他坑来说也是这样,万恶的立绘商法……
不仅仅只有我们整天被日厂定价烦到没边,就连日本人自己,也经常忍不住吐槽这个问题,并拿中国的周边进行惨烈对比。受日本周边价位所害许久的中国网友们,也纷纷评论吐槽。
以防万一你需要一个价格对比:
1900日元≈8
@手谈姬
PS5又被完全破解了?
毫无疑问,在主机这个领域,破解永远是一个绕不开的命题。对于某些技术大佬来说,这种与厂家的攻坚比起游戏来更能让他们疯狂分泌多巴胺。就在前几天,PS被完全破解的消息再一次传了出来。
这种消息其实每年都会出现几次,不过这次不一样,这次这个代号为Relapse的玩意是一个完整的漏洞利用链,从浏览器入口一路捅到内核物理内存读写权限,支持固件版本从7.00到13.60,覆盖初版厚机、Slim薄机,甚至连去年刚
@手谈姬
5 赞
妻子患病无法治愈,纯爱战神丈夫拉着她制作的游戏好评如潮
前段时间,姬曾经写文章安利过一个好评多多的Steam游戏,名字叫《针影裁梦》,是个超级有真实感(也能一本正经搞抽象)的裁缝模拟器。
游戏已经发售两周有余,好评率仍然坚挺如初。在评论区里,除了对游戏风格的赞赏外,姬见过最多的好评,莫过于称赞它的真实性——衣服尺码是符合现实人体的,整活是顺理成章的,做衣服并不是那么容易的事情,但做出好衣服的成就感简直高到爆炸。
那么,为什么这个只有几人的工作室能把它做
@手谈姬
8 赞
2 回复
狐主任携超强纪录片再临B站,播放量却一言难尽……
我们的国家、我们的故乡、我们生活的土地,是个什么样的地方呢?
社会主义国家,有56个民族,陆地面积大概960万平方千米,位于亚洲东部,西高东低,国宝是黑白毛茸茸……这些都没错,但只有这些的话,并不足以完全概括这个美丽又富饶的国家。
在广阔的国土之上,除了人民,还有数不胜数的动物、植物。它们有一些就在我们身边,但有一些是我们在日常生活里接触不到的——除了对生物方面有特别兴趣的人以外,很少有人会去主动
@手谈姬
2 赞
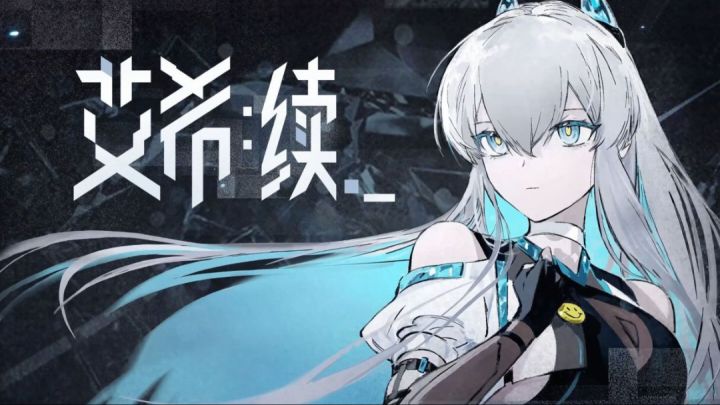
艾希团队新作《艾希:续》官方回应称不会因众筹金额过高而跳票
10月1日,《艾希》十周年续作《艾希:续》在摩点开启Steam版众筹,目标仅1万元,首日即被玩家冲到超目标数百倍:九游早间口径已筹超400万元、支持近2.9万人、登24小时热度榜第一;摩点项目页午间截图显示约514.14万元、37402人、达成率51412.52%,后续金额仍会随时间变动
面对超募,制作人老马克肖当日回应:优先保证2027年5月1日本体按时上线与完成度,不让高筹款变成无限加需求,在
@阿咩咩小喵
59 赞
18 回复