
下载 App

惊艳同行,震撼日本的技术,被《异环》主动公开了
昨天 15:356 浏览综合
细节抠到位,玩家才会来。
整理/九莲宝灯
或许还有人记得,《异环》这款产品如今能够拥有这么高的关注度,最初是从2024年的首曝PV开始的。
这段PV在B站一经发布,播放量很快破了千万。而玩家们之所以对它如此关注,除了都市题材这个被我们反复提及的原因外,还有一个在当时看来简直不可思议的技术——城市场景的无缝加载。
在游戏里,不管进出任何一家商店、建筑,游戏都没有设计室内外加载流程,更重要的是,这一切都是跨平台的,不光PC可以这么做,移动端也同样可以做到。我们可以说,这项技术几乎是《异环》这款游戏成立的基石。
这种技术实力,甚至还引发了日本从业者的集体反思,为什么日本就做不出这样的游戏。有人感慨道,“如果你是日本游戏行业人士,并且玩过《异环》,应该能理解,这个游戏的制作精良程度非同寻常。我爬到海特洛的最高处,用PC版和iOS版分别拍照对比了一下,两者都能毫无压力地游玩。你们应该能明白这有多么可怕。”
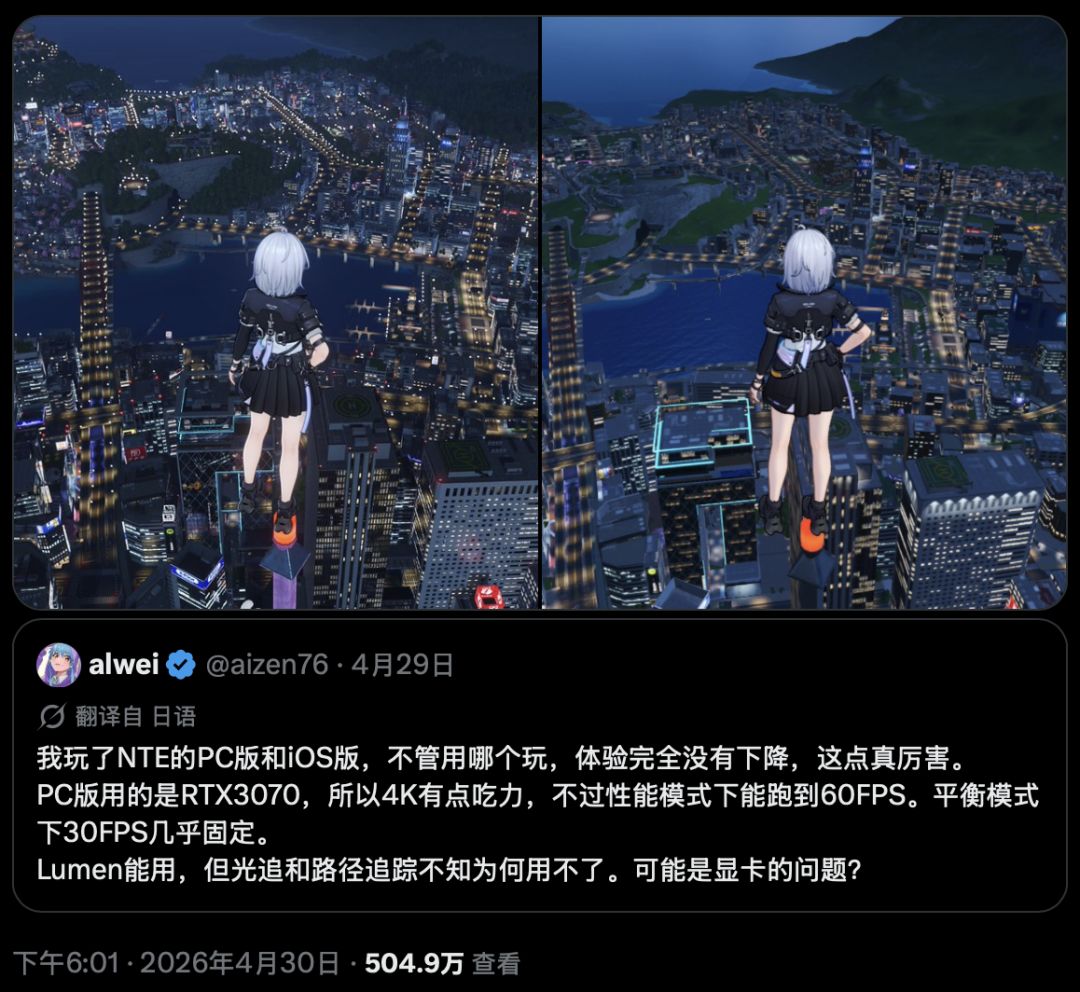
但对于工程团队来说,这种「毫无压力」背后其实面临不小的挑战:手机和PC的硬件预算天差地别,要在两端同时跑通同一座全动态、无黑屏读条的城市,性能到底是怎么省出来的?
而就在不久前,完美世界把这项「可怕」技术背后的经验公布了出来。
在上周五的Unreal Fest Shanghai 26上,完美世界游戏技术中台发表了名为《<异环>跨平台无缝城市的技术实践》的演讲。在演讲中,他们详细讲述了《异环》如何在手机等平台上,利用有限的性能做到城市场景的无缝切换,以及他们关于Lumen多平台优化的经验。
01
无缝加载,
要从缝里省资源
《异环》在都市题材之外,最令玩家印象深刻的,是进出商店和建筑,没有室内外加载。PC 能这么走,移动端也能。
首先是游戏内的各种资源无缝加载。
在演讲的一开始,他们先播放了一段演示视频。在这段视频中,玩家正在城市的海底隧道中开车,突然间,隧道中光线一闪,这个海底隧道完全变成了奇幻的海底世界。
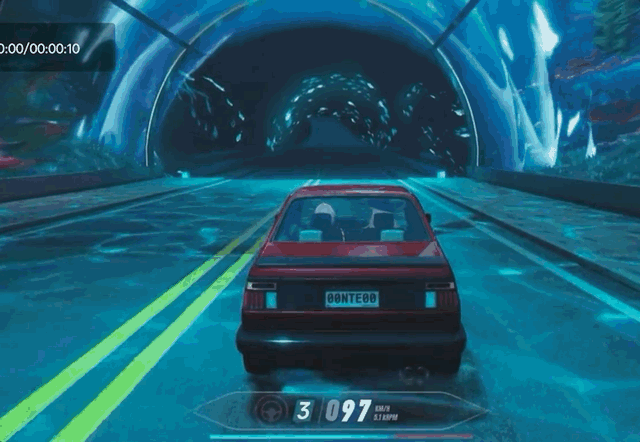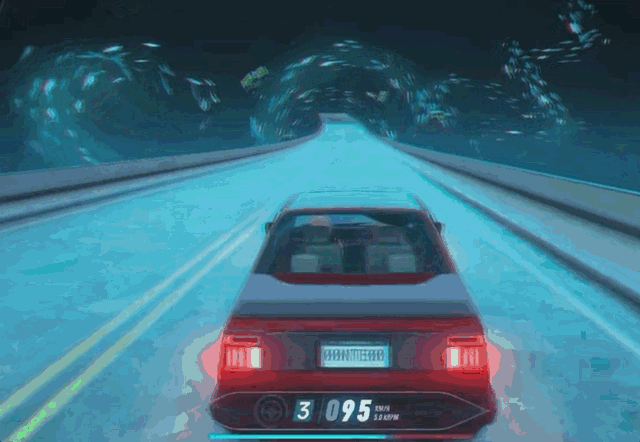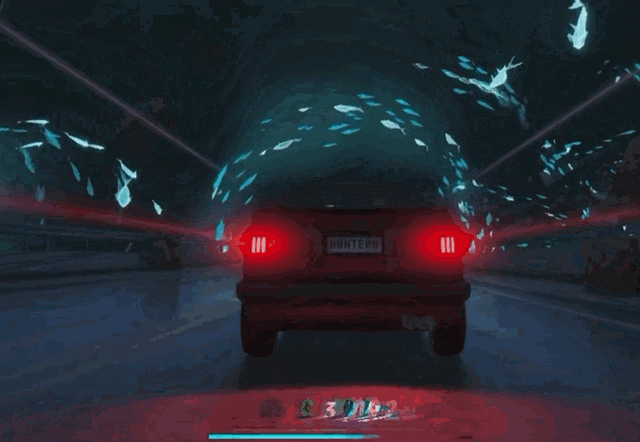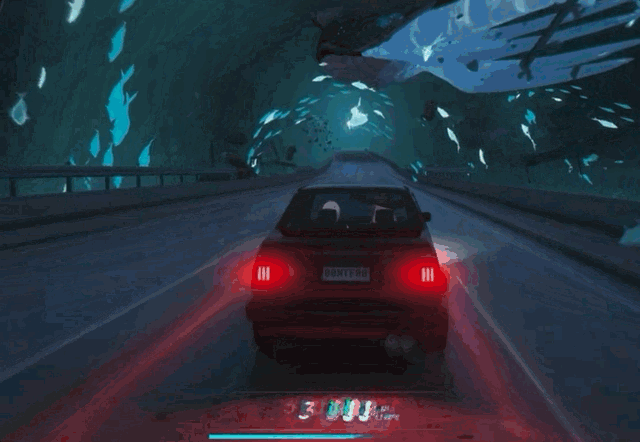
这个过程光是看着就不简单:起初,玩家身处大世界地图中,不能意识到前方就是另一个世界;而光线闪烁后,玩家需要一瞬间进入副本。在这当中,车辆全程处于高速移动状态,穿梭的过程不仅不能有任何加载卡顿,进入副本后,道路也要在一瞬间接住移动的车。
另外,从大世界进副本还有一个问题:镜头也会重置。那就意味着他们需要对齐前后的镜头状态,避免出现镜头瞬移的感觉。
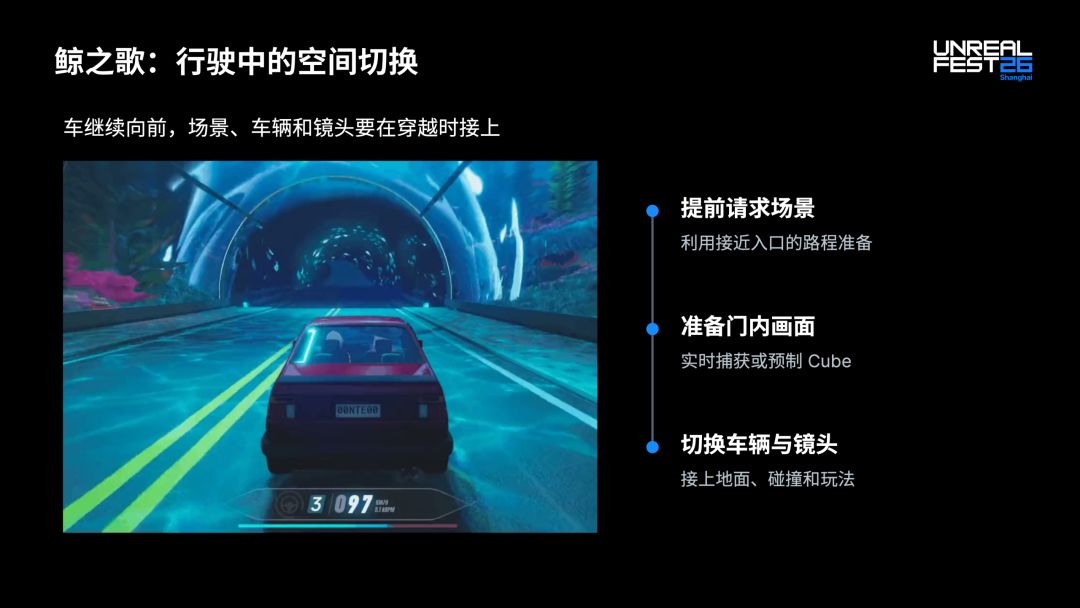
这里每件事都够麻烦的。Zhenyang介绍了他们的解法:
首先,副本场景加载肯定需要时间,这只能提前做。车还没到,外围的触发区就要开始预加载。资源一口气全读会导致卡顿,那就切成段、分到不同的layer里,车往前开一段,读一段。
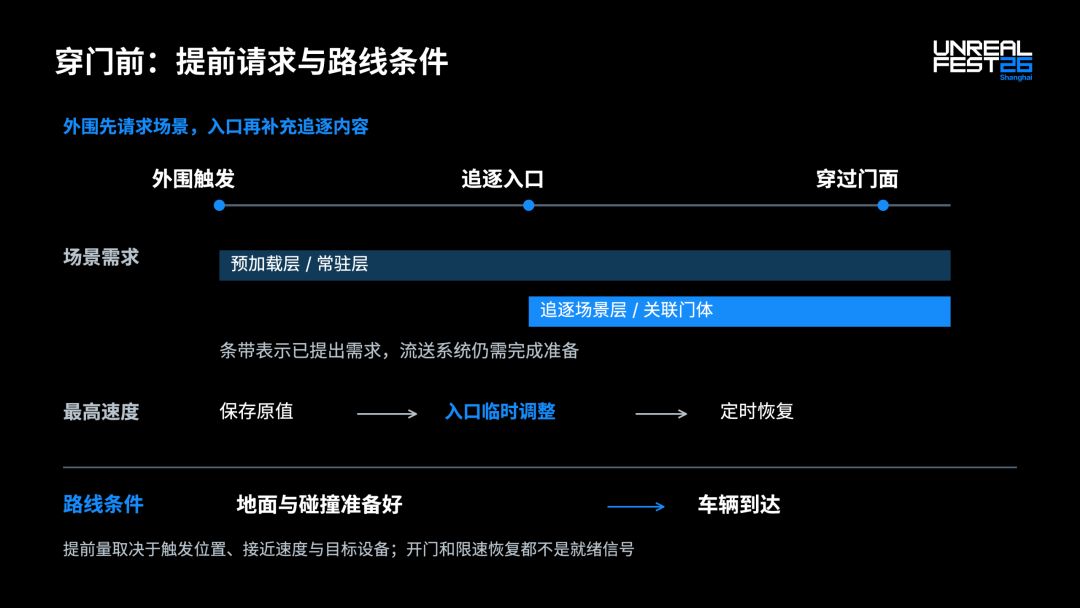
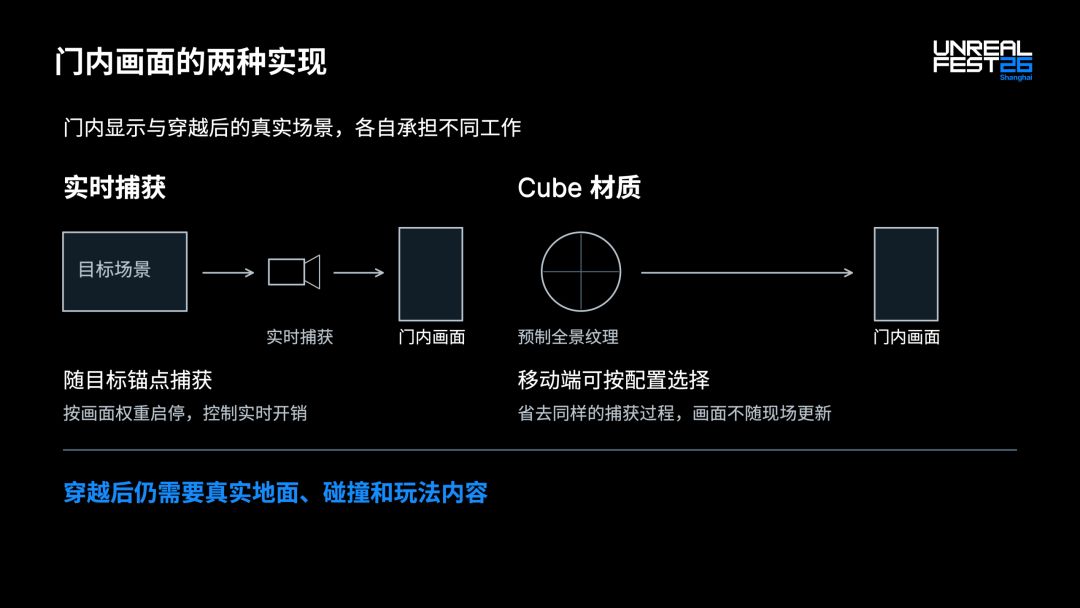
玩家在大世界看到的副本内景象,他们用了两套方案来呈现。
对于性能比较足的PC端设备,他们会直接拿一台虚拟摄像机去对面渲,映射到传送门内,门外看到的是对面的实时动态,车靠近时两边画面混合程度变高,不用为了省开销把这台摄像机临时关掉。
对于性能有限的移动端,他们选择提前烘焙好静态贴图,省掉整个额外渲染的开销,当然,代价就是门里那幅画不会动。
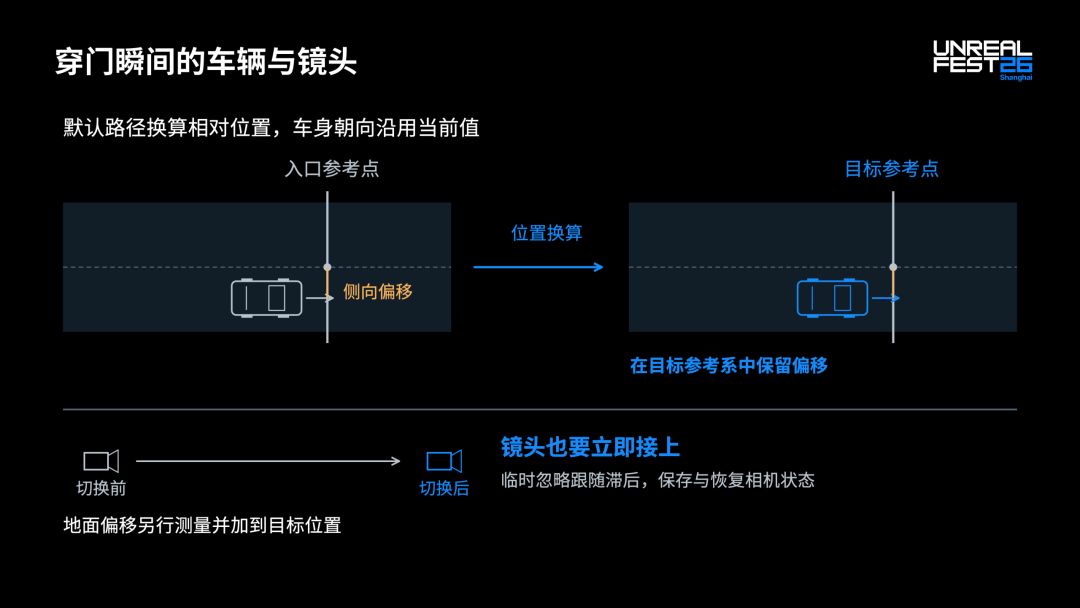
关于进副本的镜头对接,他们的解法则是让系统保留进场的侧向偏移,比如玩家从左边进去,那么进副本时还得在左边。高度也要衔接上,把当前车辆和地面的高度差直接叠到目标位置,免得车陷下去或者悬空。还有一个很细的处理是,穿越那一瞬间会临时取消相机的跟随,过去了再把镜头对接好。
但以上种种,还只是玩家能直观看到的玩法编排。车之所以能毫无卡顿地开上新路段,是因为当这些场景资源真正交给硬件加载时,底层已经在CPU侧做好了严密的分摊。
这些需要加载的资源进入内存后,想要让内容真正运行、显示出来,还得创建、注册、按需求建一个空间,这些都要CPU来做,一旦集中堆在某一帧里就会瞬间卡顿。
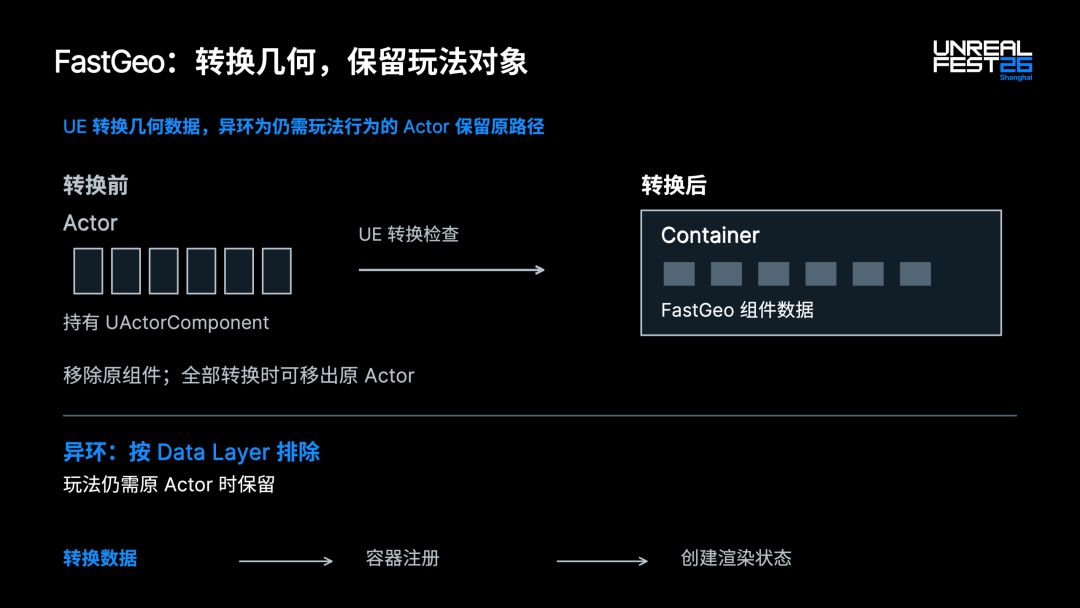
为了给CPU减负,《异环》的解法逻辑依旧是分批处理。UE的StaticMeshActor是单个管理的,城市里几万个资源很要命,因此他们接入了Mass框架里用于管理图形的FastGeo实验性插件,它能将很多Actor转换为组件数据,并且用一个组件数据来进行接管,以Container作为批次统一接管,转完就从观察列表里摘掉。
此外,他们还会再叠一层按Data Layer来做排除,跟玩法有关的资源定向保留,其余的按规则批量转换,按照优先级处理。
但就算这样,批量创建这件事还是会在同一帧爆发,所以他们还要再分批。不管新建了多少组件数据,游戏每一帧的时间预算用完后,没做完的数据只能去下一帧重新排队。
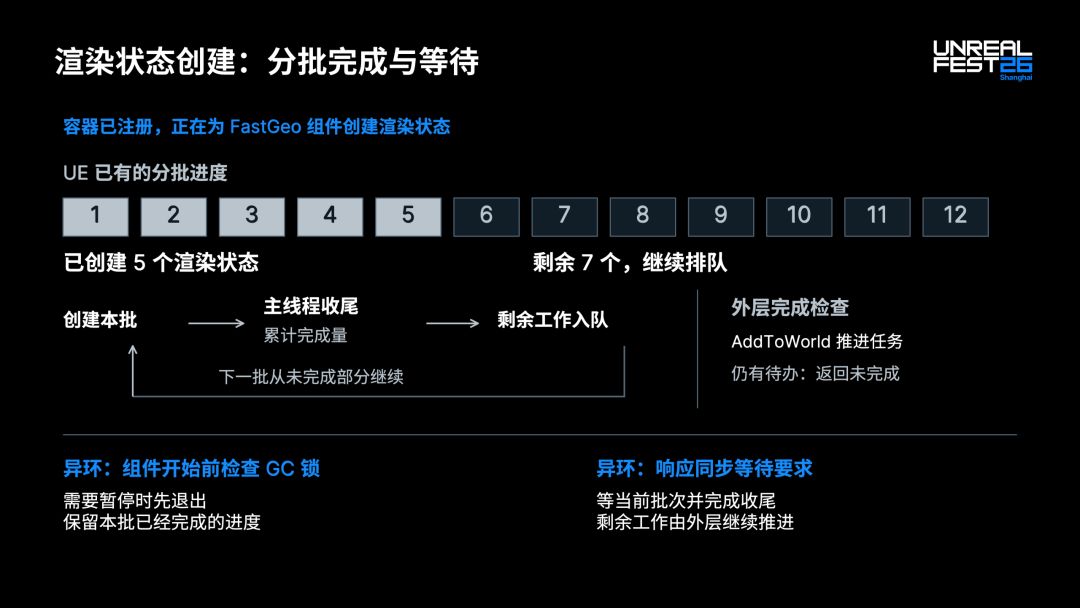
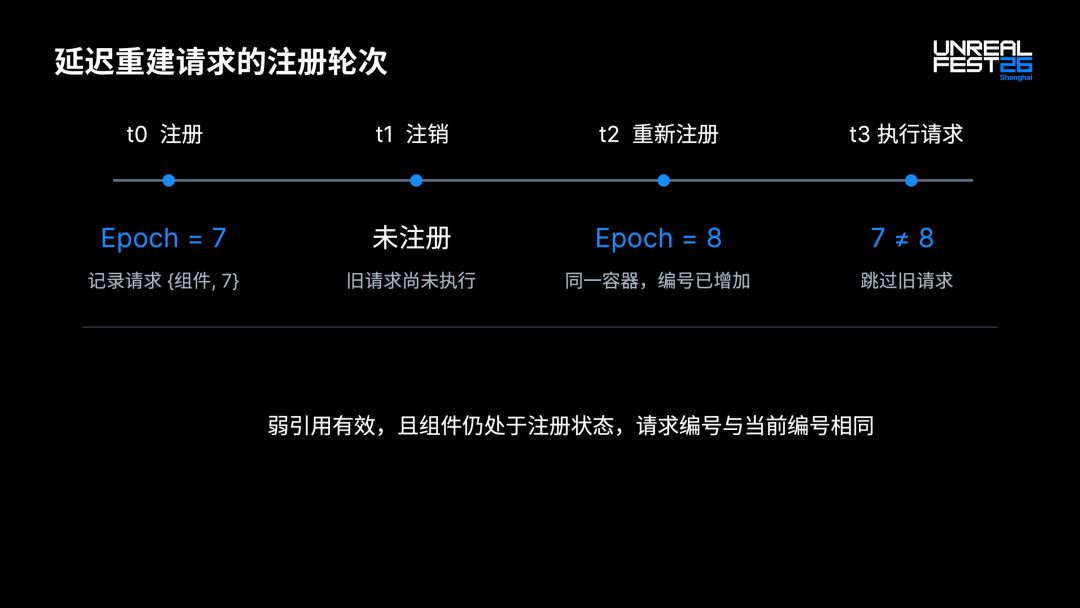
Zhenyang还提示说,FastGeo有些更新请求不是立刻执行,而是会打包、攒到帧末再跑。可在这中间,那个对象可能已经被注销又重新注册过,等你执行时它已经是另一个东西,算完就是白算。他们为此加了一道注册信息的校验,执行前再核对一次,过期就直接跳过。
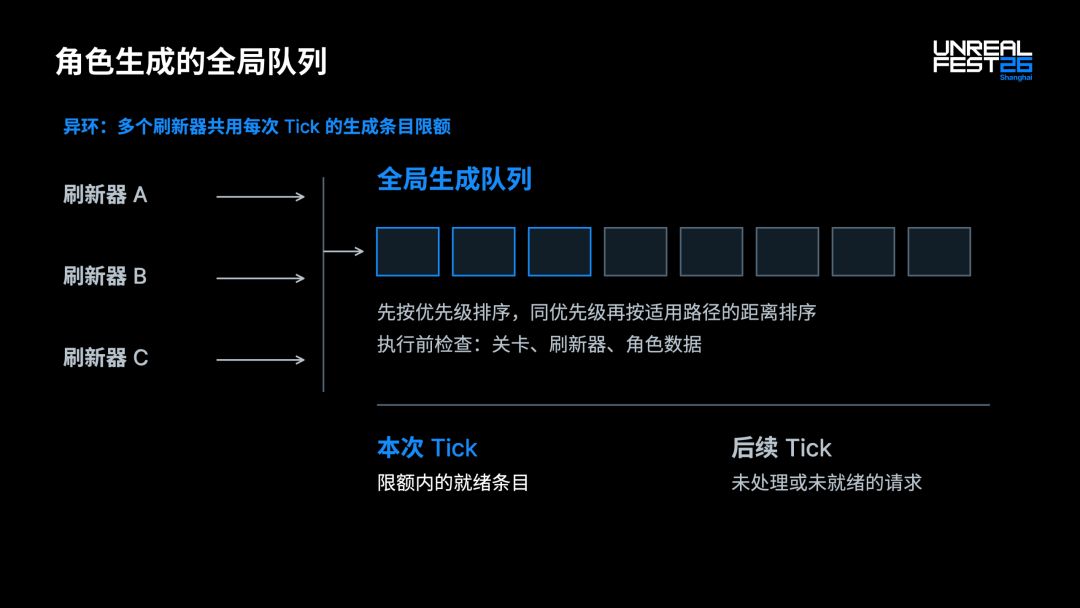
静态建筑能靠提前分段和跨帧排队解决,但动态对象不行。当玩家在城市里穿行时,大量NPC和车辆会同时涌入刷新范围,如果不加管控,静态场景刚省下来的CPU预算马上又会被动态创建吃光。《异环》把所有这样的请求塞进一个全局队列,共享同一份刷新额度,按优先级调度,再按离玩家的距离排序,近的先出。
而这些NPC和车辆进了画面之后,怎么维持运行又是另一笔账。
他们详细讲了这方面性能资源配额的逻辑。他们首先要做的,是给人物位置给每个NPC定好标签。
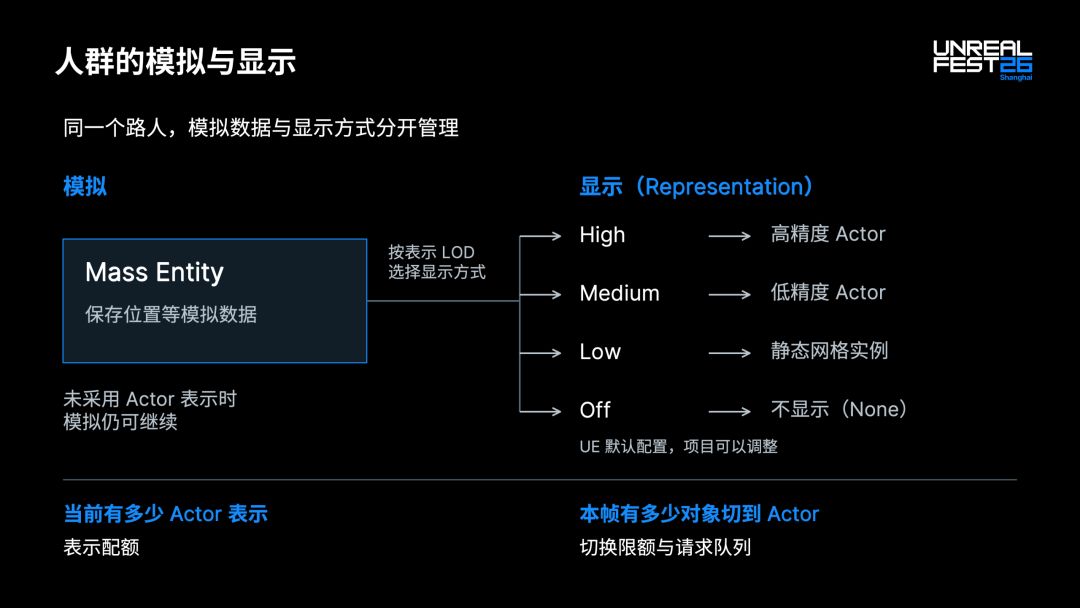
有了标签,接下来是名额分配。假设这一帧只给4个名额,那其中会有2个基础名额、2个保留名额,保留名额留给上一帧的高档次对象,而这一帧最近的两个则拿走基础名额。
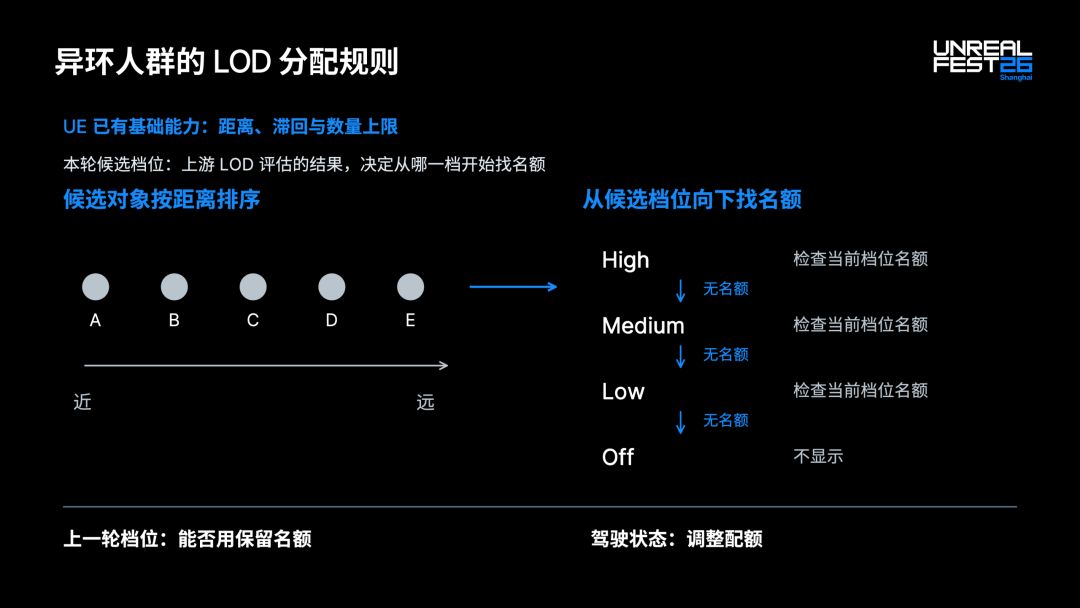
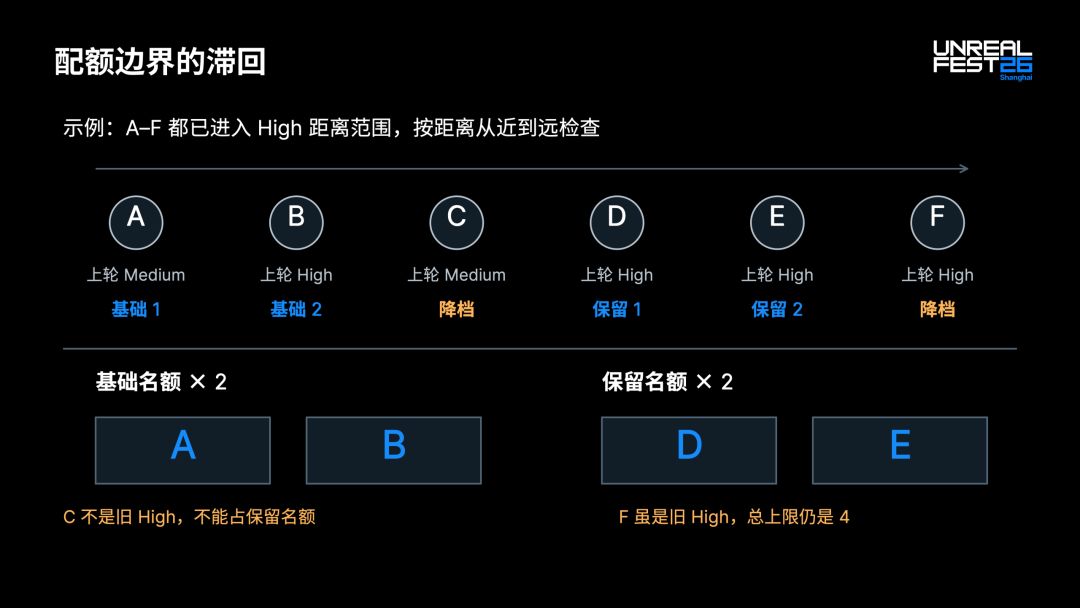
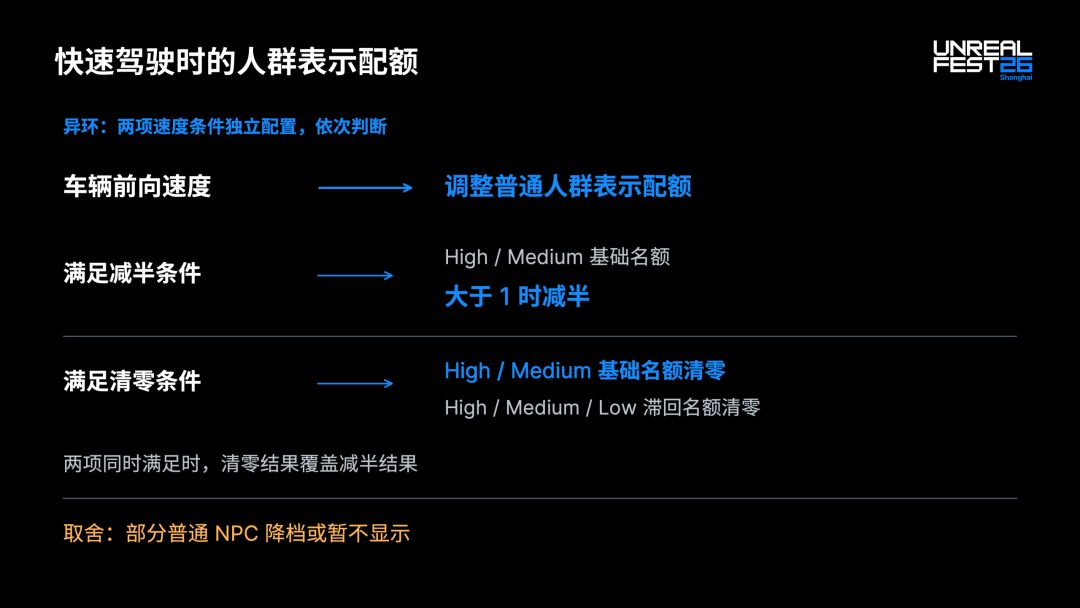
而在实际运营过程中,他们在这个逻辑上又加了两个新的规则。一个是车速够快,系统就把远处的路人降档甚至隐藏,反正那个时候玩家也看不清;
另一个则是删掉中间态,原本一个NPC从排队到显示出来,中间会先给一个过渡表现,后来他们直接把这一层删了,因为玩家高速移动时,这个NPC可能请求还没批下来就已经出了画面,那个过渡纯属白算。
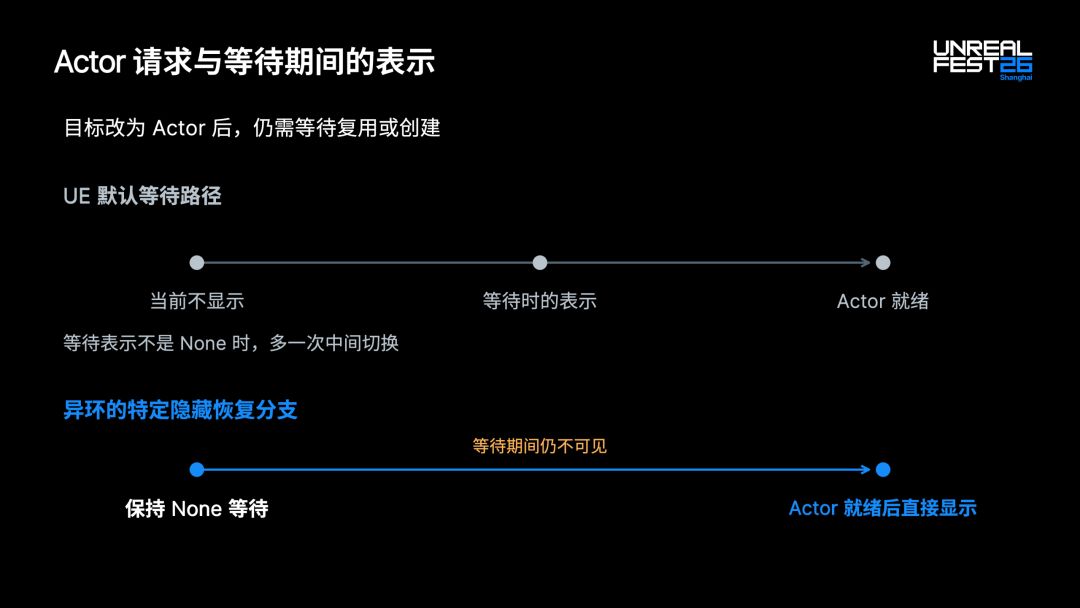
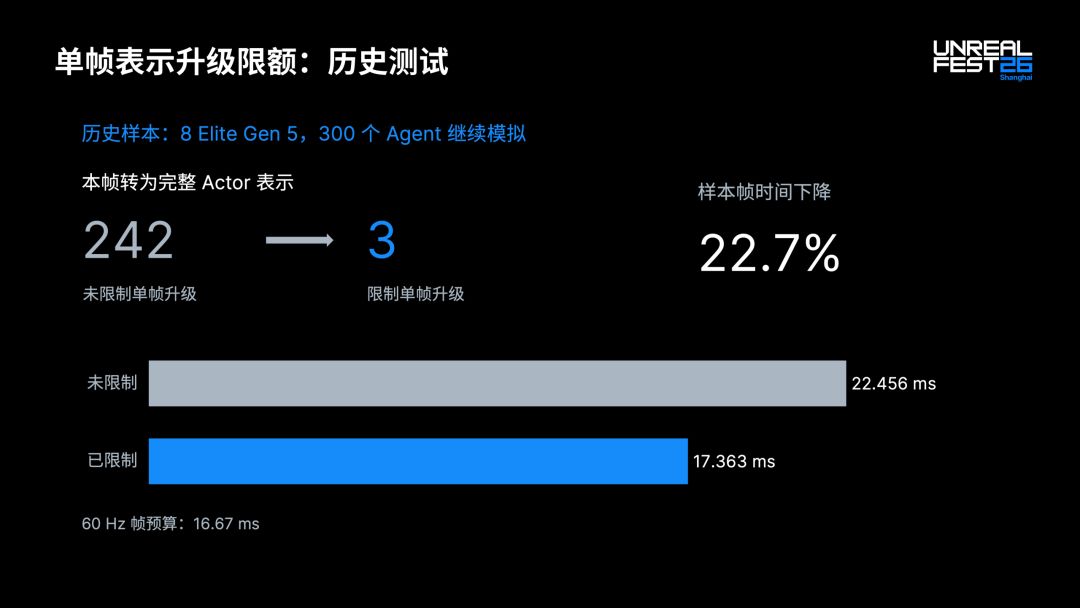
Zhenyang估算,如果他们关掉限额,哪怕原地挂机,一帧都要触发242次升降级。而开了限额后,只可以降到3次,帧耗时能从22毫秒掉到17毫秒。
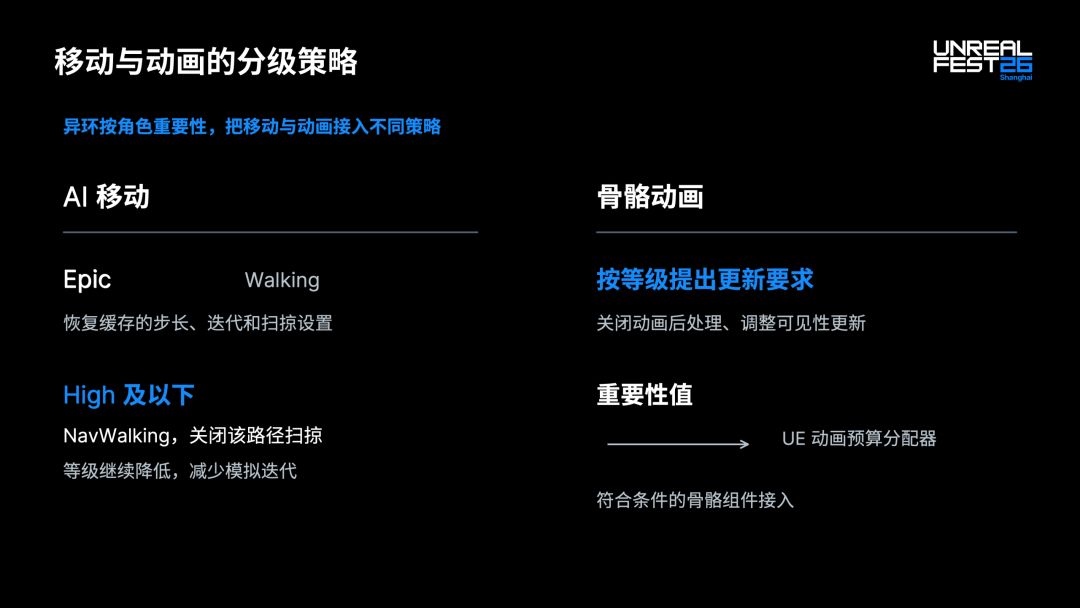
但也有些NPC不能这样降,比如带任务的角色。这些角色的移动和动画不能常规处理,因此还要再设计策略。
对于最高优先级对象,他们会恢复缓存的各类设置,而其他的就交给Navwalking,Trace关掉,回到近处再恢复。动画也会按等级提出不同的更新要求。
除了距离,玩法状态也会影响他们的规则,例如战斗、对话、乘坐电梯。这些对象同样也需要保留高优先级。
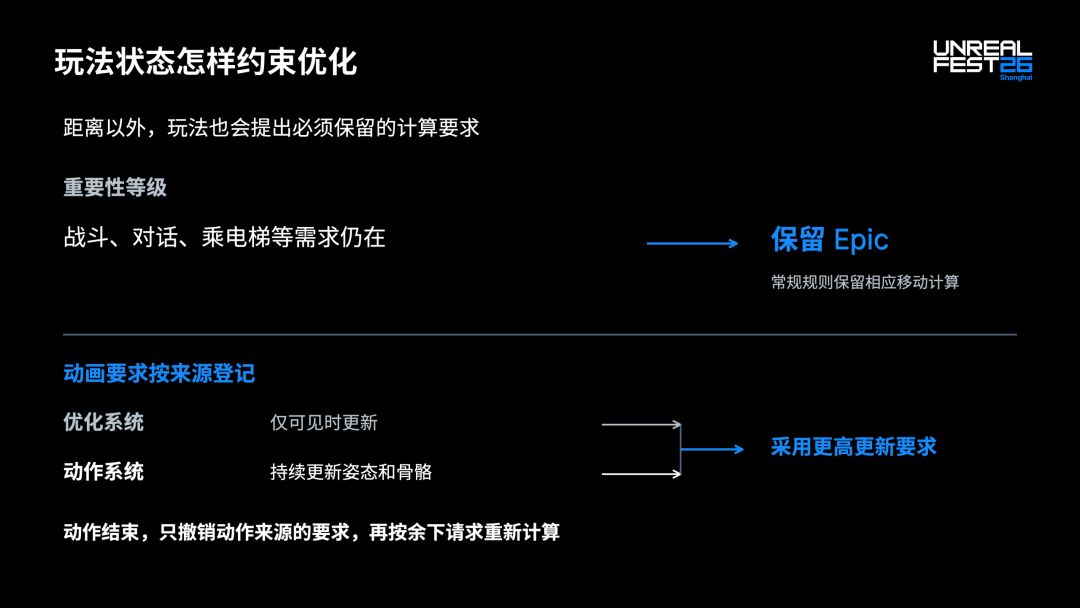
一套逻辑下来,他们既通过进行评估,砍掉了远端的其他开销,又保证了玩法的需要。但除此之外,他们还需要整理很多环境动画策略。
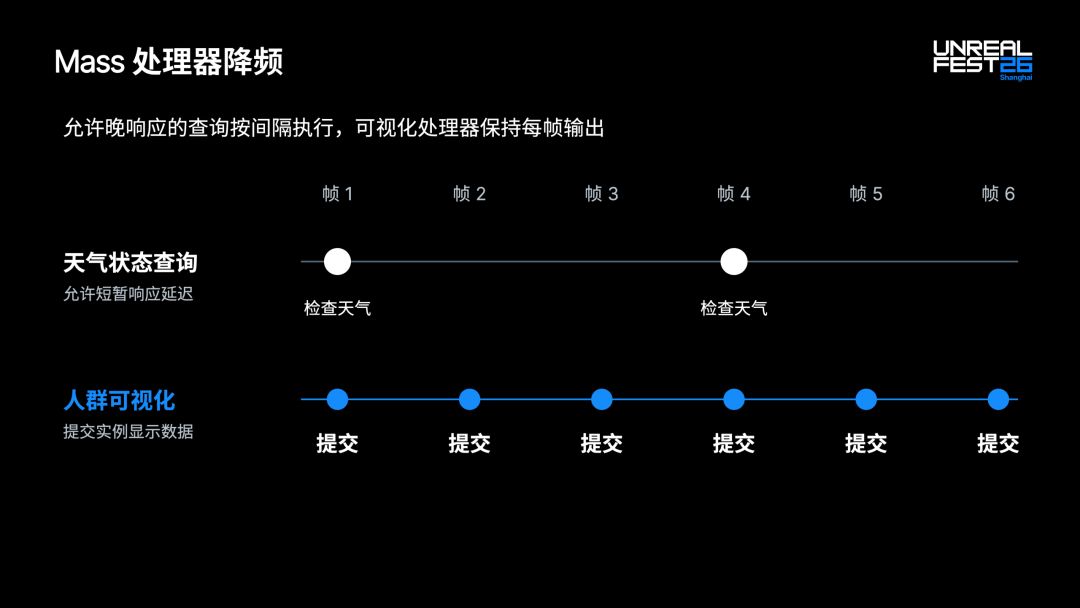
对于天气、撑伞这类虽然会动态变化,但响应速度不用精准到每一帧的状态,他们会让状态查询按间隔执行,抽帧处理。
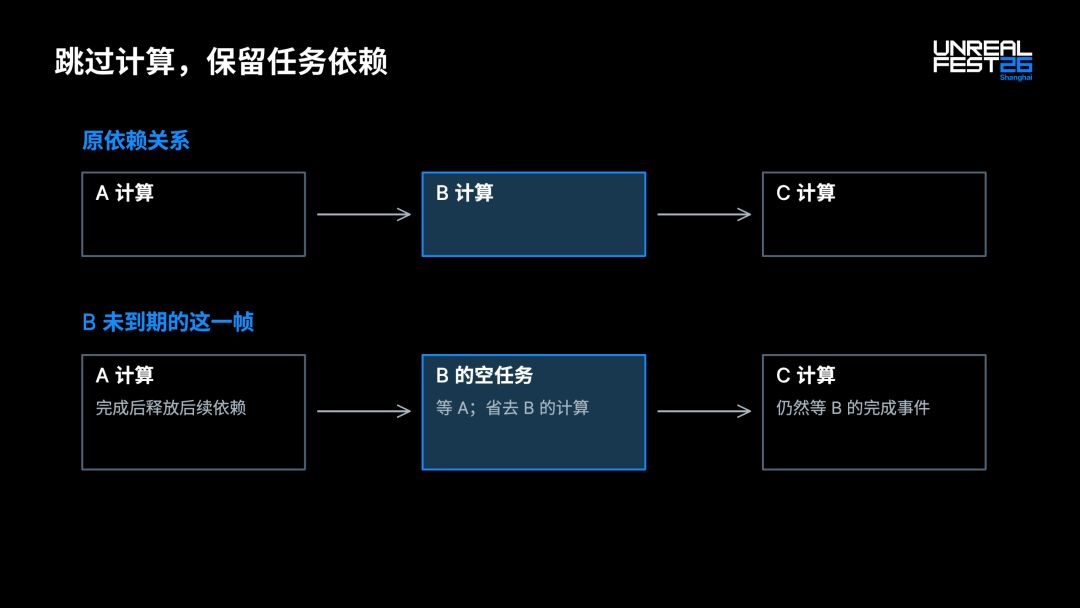
但抽帧放在底层的任务调度里也会遇到问题。因为Mass框架里的任务有时是有依赖链的,C等B,B等A,这一帧B因为没到执行时间被跳过,C就会失去对A的等待关系。对此,他们的补法是留一个不干活的空任务占位,什么都不算,但保证顺序不断。观察者的数据则用三缓冲,写不进去就沿用上一帧的旧快照。
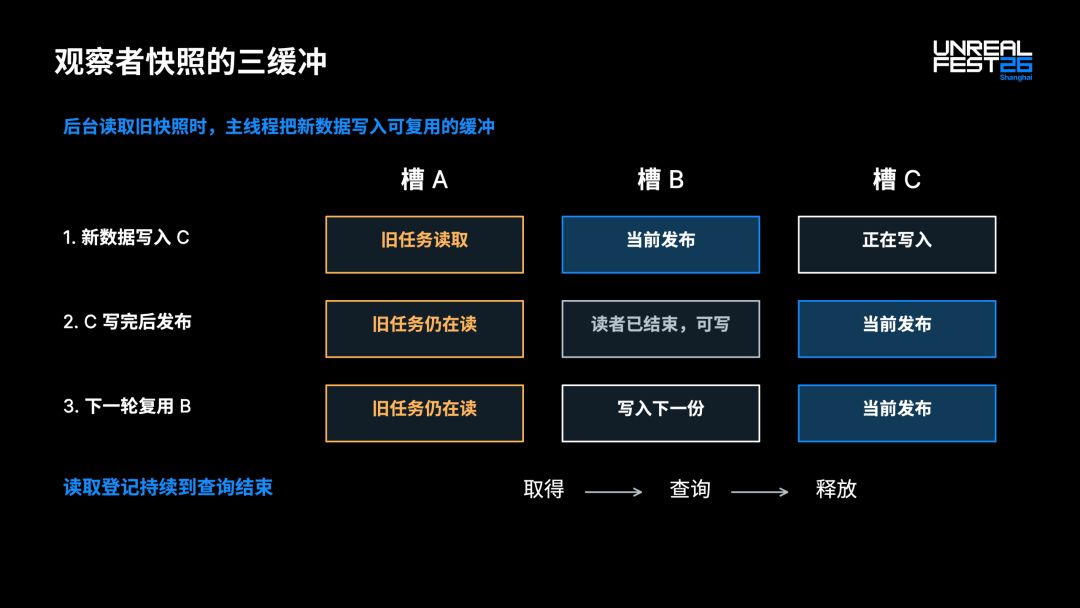
《异环》的CPU优化,是无数的时间分析,思路可以简单被总结为,场景应用画面中的每一帧都定下优先级,组建好时序,随后通过减少无用的内存创建、决策率,同时控制对象数量,动画帧率,根据调度Mass的逻辑执行频率来处理这个项目。
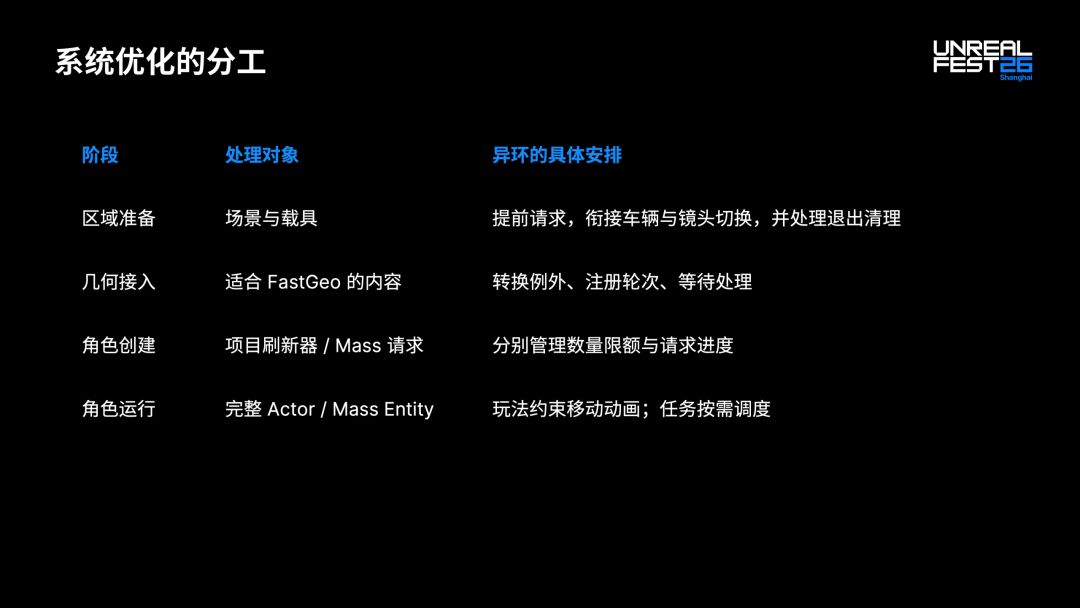
这类优化实际上是一个性能与玩法本身的平衡,排队换取的这个帧率的成本,降频换取 CPU 的一个开放。就是靠这一套策略,《异环》才能在这种具有高度逻辑强度的开放世界里,形成一种闭环。
02
移动端和PC,
Lumen的两种优化方向
但光让城市不卡顿还不够。开头那位日本从业者之所以在海特洛高处对比PC和iOS时感到震撼,还因为两边看到的都是一座光影鲜活的城市。在演讲下半场,Tianli就拆解了另一块硬骨头:他们是怎么把UE那套吃性能的完整实时光照系统 Lumen,同时塞进手机和PC里的。
一直关注《异环》B 站动态的玩家,想必对 9 月那条三方合作演示印象深刻:异环联合骁龙、虚幻引擎,公开了移动端 Lumen实机演示,开关效果对比差距直观,当时就让不少玩家直呼惊艳。
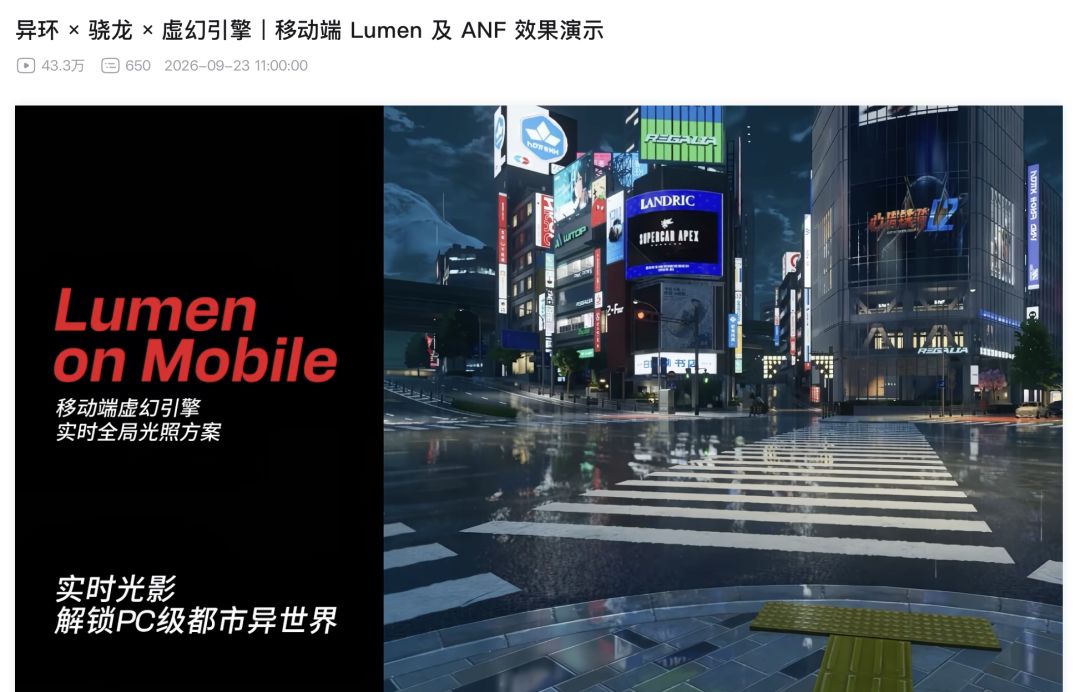
要知道,Lumen 本是虚幻引擎为 PC 与次世代主机设计的渲染技术,依靠实时追踪间接光照与环境反射,资源开销极高,受手机算力、散热、功耗限制,长期以来都是移动端的禁区。在此之前,也从来没有同规模的跨端开放世界游戏,敢尝试在移动端落地 Lumen。《异环》算是开了业界先河。
他们的目标很明确:作为一款拥有 12 个昼夜时段、3 种天气系统的全动态城市游戏,预烘焙的静态光影很难充分表现场景的实时变化。他们更希望让 Lumen 能够在高配移动端上稳定运行,以带给玩家能够比肩 PC 端、鲜活连贯的动态光影体验。
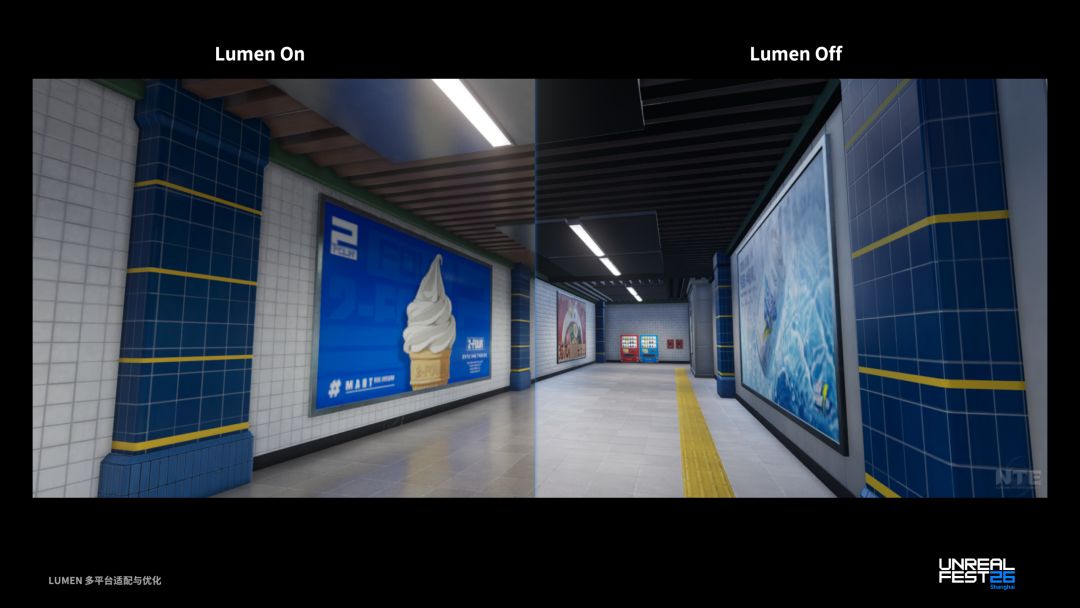
于是,《异环》联合虚幻引擎与骁龙平台,打磨出一套深度优化方案——从底层的引擎适配到软硬件协同调优,夯实了Lumen在移动端落地的技术底座。团队还需要完成全链路的工程接入、正确性修复、性能调优和实机验证。最终实现在移动端完整呈现GI(全局光照)+反射的Lumen体验。
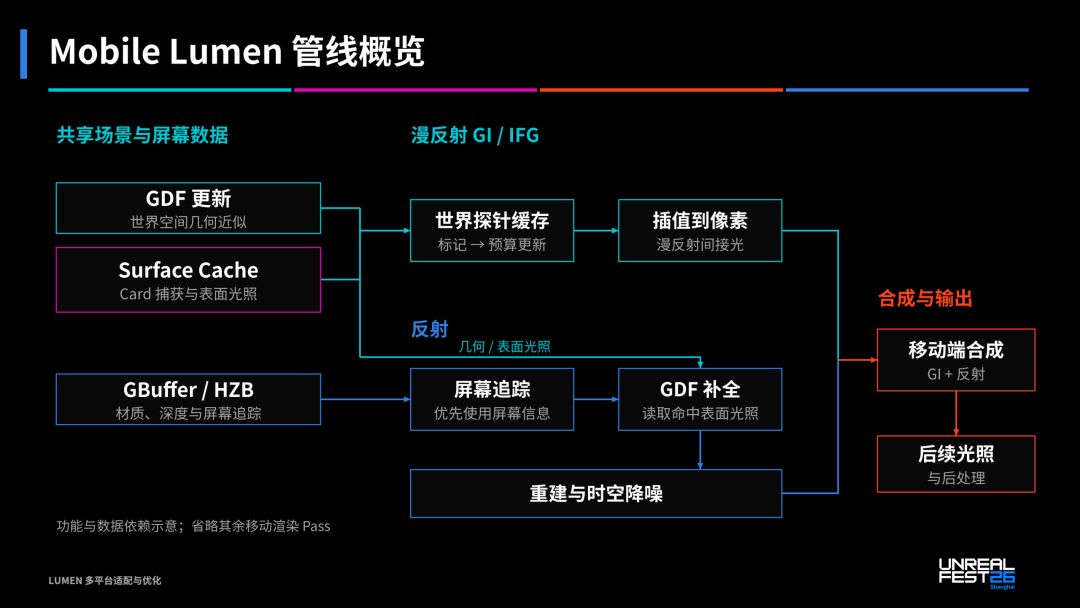
先来说说GI(全局光照)的部分,想在移动端实现GI到底要怎么做?他们对比了两条路。
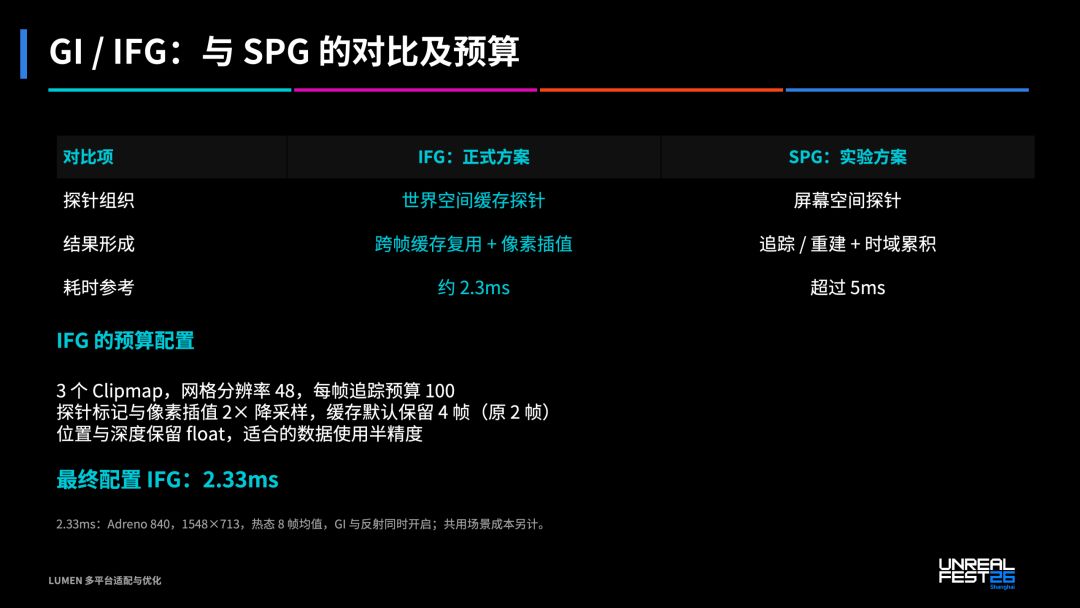
一条叫IFG (Irradiance Field Gather,辐照度场采集),这是UE 5.8随Lumen Lite引入的低成本方案。Radiance Cache探针布在世界空间,跨帧缓存复用,再靠像素插值铺到屏幕上。
另一条则是UE更常见的SPG(Screen Probe Gather,屏幕探针采集),探针跟随屏幕,靠追踪重建加时域累积,它的质量上限更高,但对性能的要求也更高。
最终他们选了IFG,因为对比下来,IFG渲染耗时仅需2.33毫秒,后者则超过5毫秒。
GI(全局光照)定了,接下来是反射。
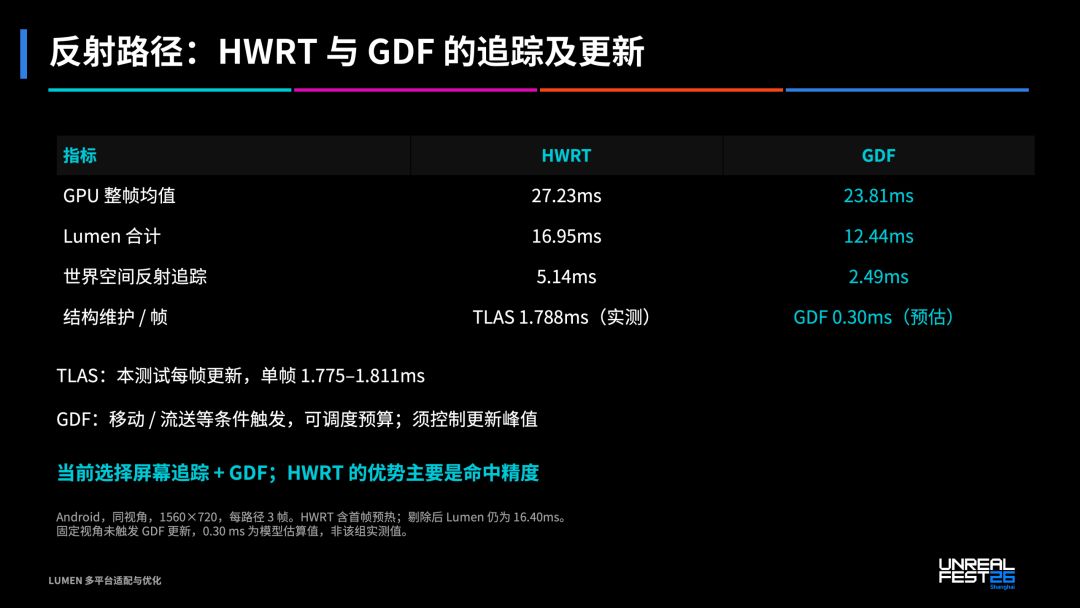
这次要比较的是HWRT(硬件光追)和GDF(全局距离场)。不论是整帧GPU均值、Lumen、世界空间反射追踪还是结构维护,GDF都更有优势。因此他们选择了屏幕追踪加GDF。硬件光追的优势在于命中精度,但这不够换回1.78毫秒的延迟。
选定方案还不算完,《异环》还分享了他们在配置测试中的细节。
他们原本让反射复用IFG的Radiance Cache,但后来发现复用会带来提前终止,而提前终止会损失接触和视差,这个代价他们不接受。因此他们还是选择改成 3×3 的时域 Box Kernel,多跑世界空间追踪。
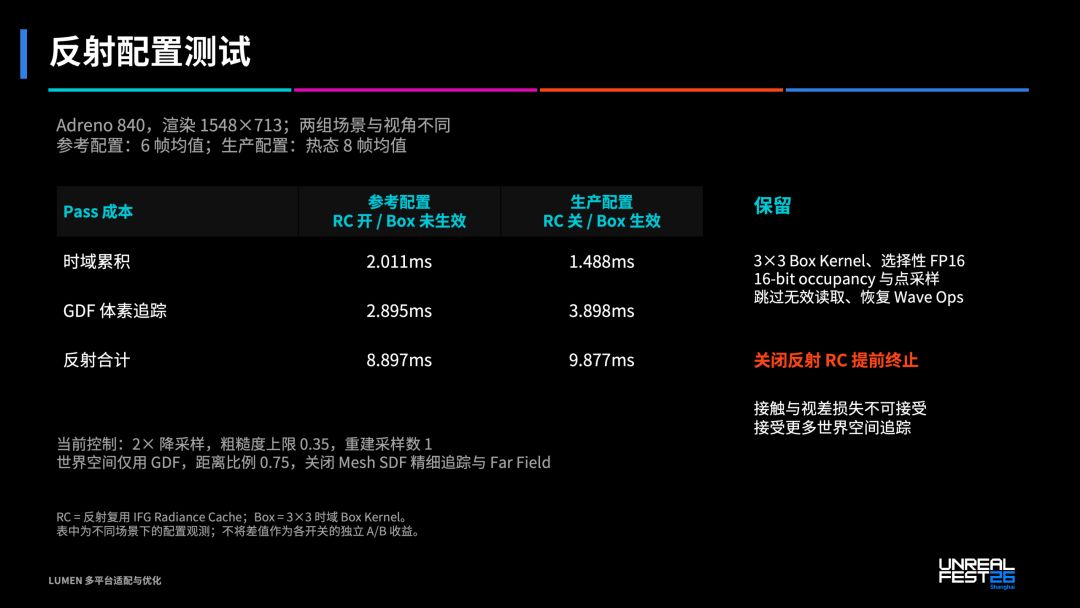
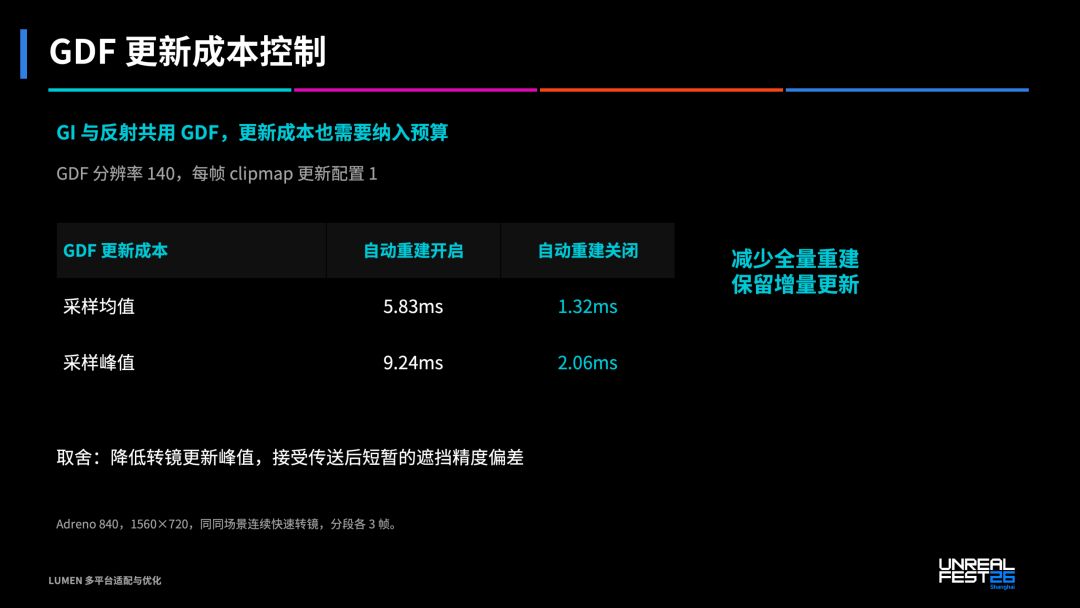
GDF 自己的更新也要进预算。分辨率140,每帧只更新1层clipmap。自动重建开着时采样均值 5.83 毫秒、峰值 9.24,关掉之后是 1.32 和 2.06。因此,他们的取舍是降低转镜的更新峰值,接受传送后短暂的遮挡精度偏差。
Surface Cache方面,《异环》移动端试过三个暗区处理方案。低精度的Radiosity SH精度不够,带遮蔽的Radiosity在一组720p测试里要多花约0.5毫秒;最后他们选择用天光兜底,避免纯黑,但封闭空间可能会有漏光边界。
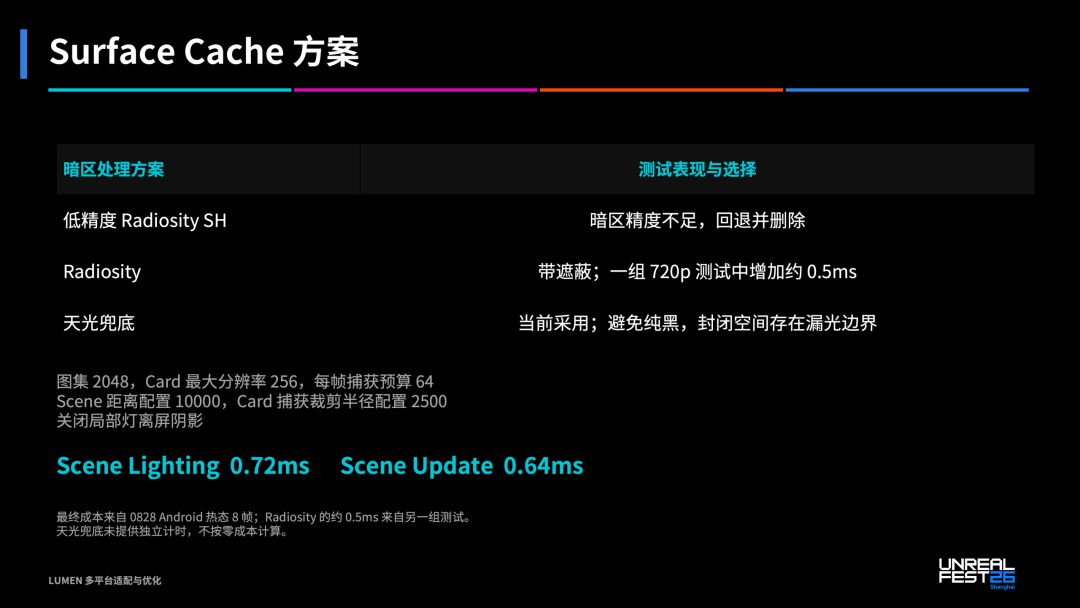
它的配置是图集 2048、Card 上限 256、每帧捕获预算 64、捕获裁剪半径 2500,关掉局部灯的离屏阴影,成本是场景光照 0.72、场景更新 0.64 毫秒。
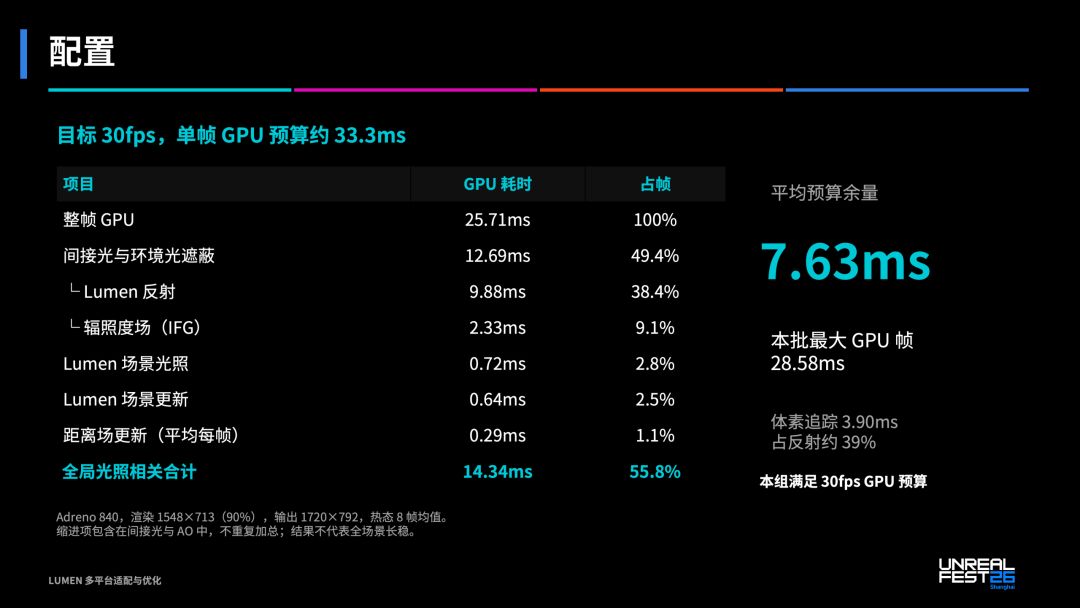
最后,他们算了一遍总账,整帧GPU25.71毫秒,Lumen 全模块(全局光照 + 反射)合计 14.34 毫秒,占整帧55.8%。平均余量7.63毫秒,本批最大帧28.58毫秒,做到了每帧33.3毫秒以内,也就保住了完整 Lumen 方案下的30帧。不过他们也提到,反射里体素追踪3.90 毫秒,将会是产品后面还要继续优化的地方。
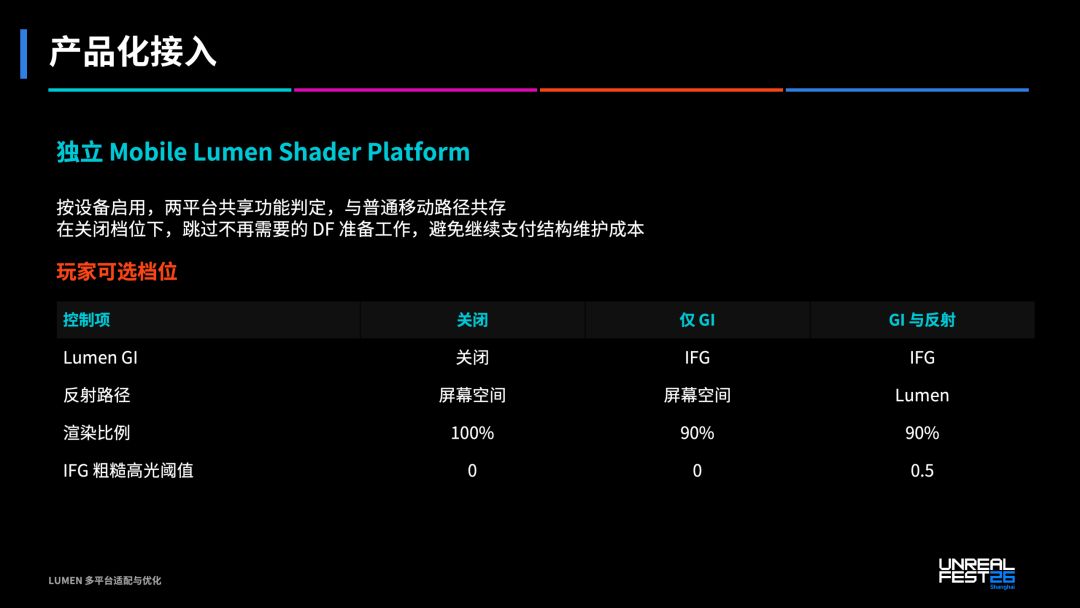
产品化上他们做了独立的平台,按设备启用,玩家可以有三档选择,关闭、仅GI,或者GI与反射,可以根据设备实际情况再做调整。
忙完移动端,在预算更宽裕的PC领域,Lumen的目标就变成了「怎么在高画质下榨取性能提高帧率」。这块的核心是VRCS(可变速率计算着色器)。
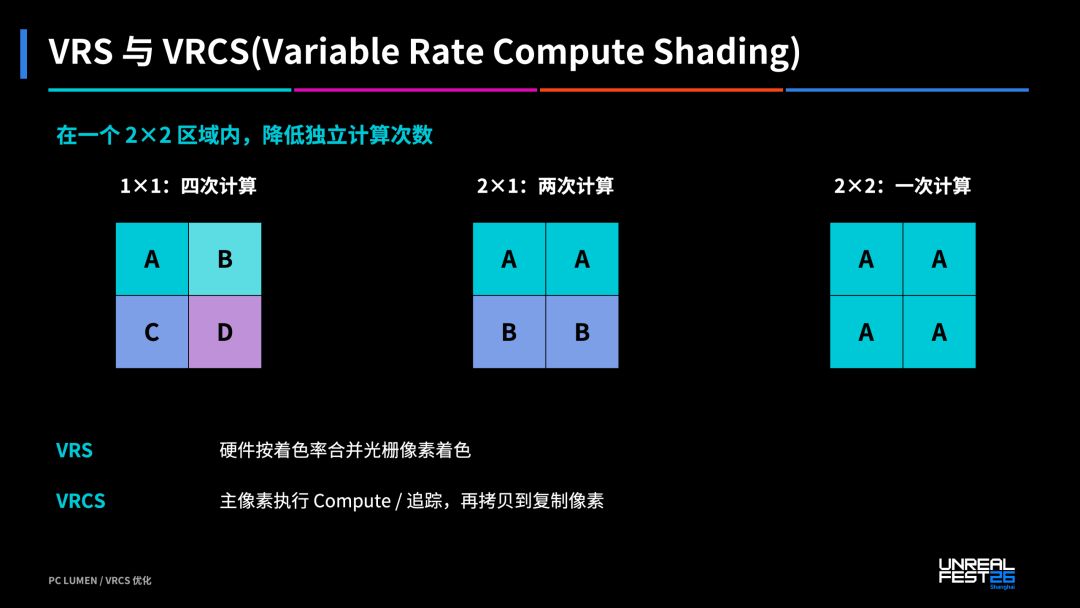
VRCS脱胎于VRS。传统的VRS是硬件在光栅阶段按着色率合并像素着色,但它对compute shader是无效的。因此VRCS把同样的想法搬到计算和追踪上,主像素执行,结果拷给复制像素。也就是说它能够省掉很多像素着色的过程。
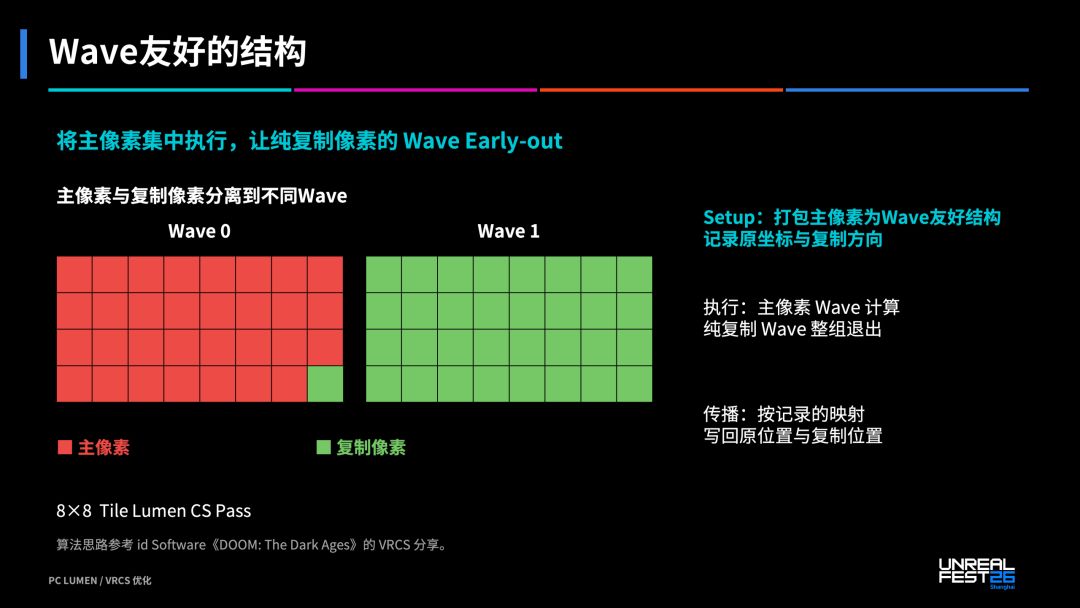
但难题在于,怎么让省下来的像素变成时间,让游戏更丝滑。换了VRCS,光追的工作就不在光栅阶段,而是在计算和光线追踪里。就算你在着色器开头让多余像素提前退出也没用,因为GPU要按Wave(通常为32个线程一组)来跑,一组里只要还有一个像素活着,整组都得陪它跑完。
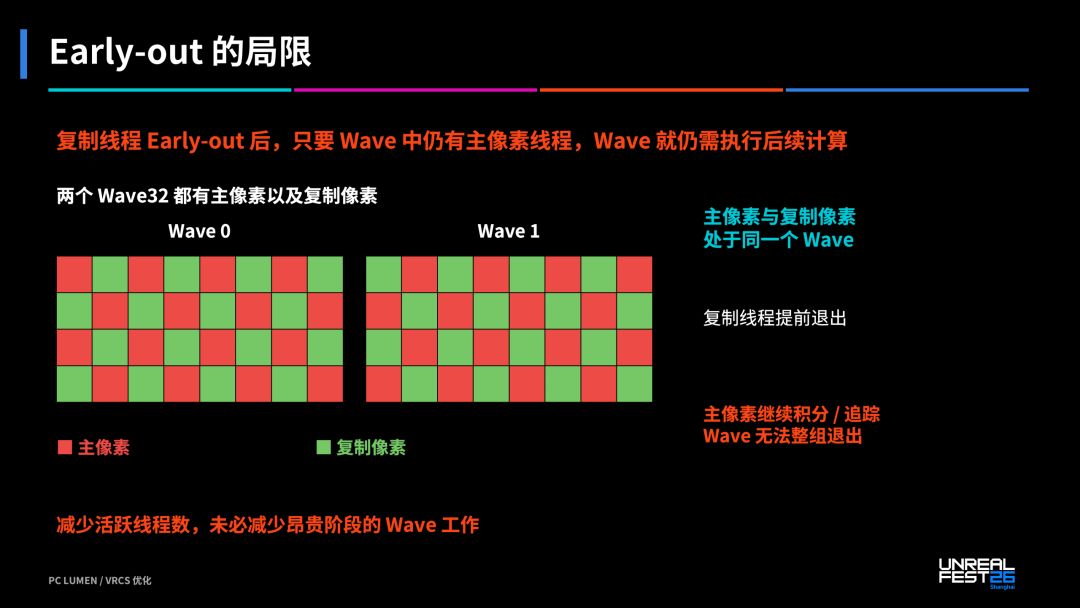
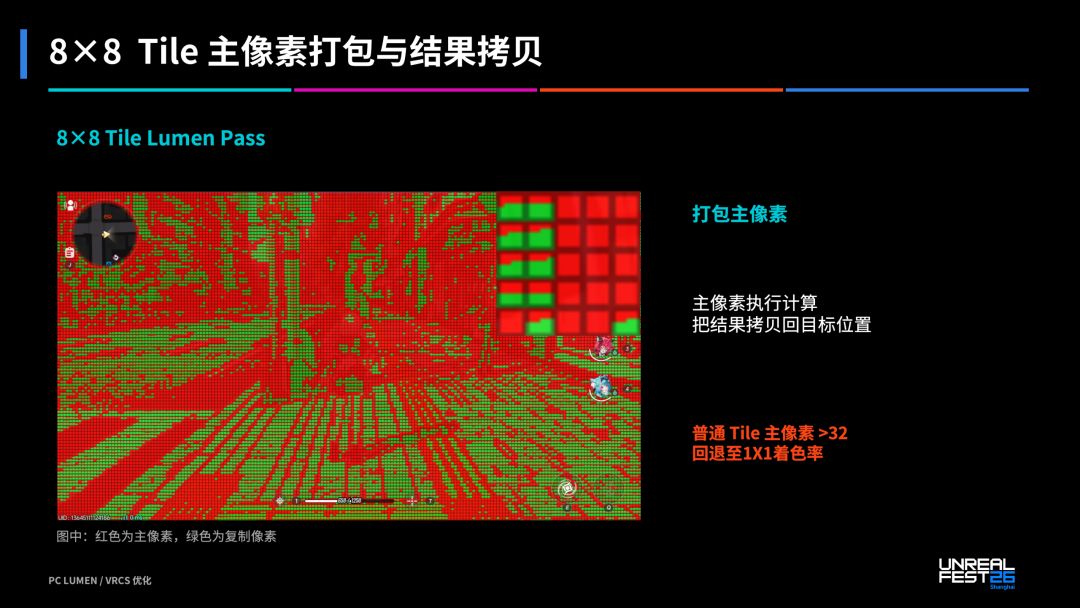
所以他们的解法是打包。先把真正要算的主像素记下来,塞进连续的线程槽位,一组全空就整组跳过,算完再按映射表把结果写回去。8×8一个tile,如果主像素不超过32个,刚好能打包塞进1个32线程组里跑完;一旦超过32个,无法进行整个Wave跳过,这个tile就直接退回全量计算。
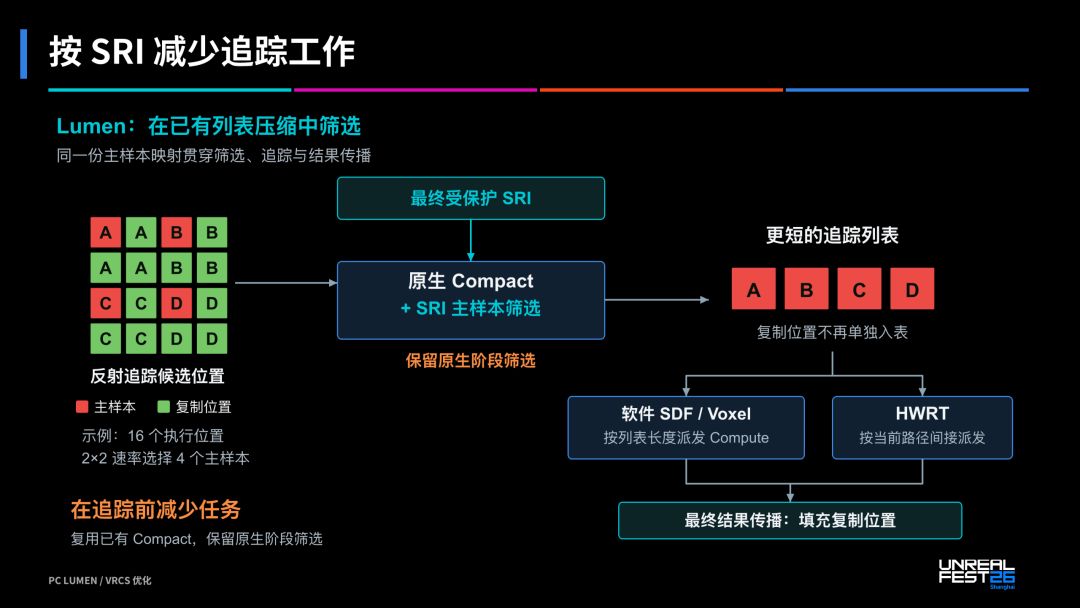
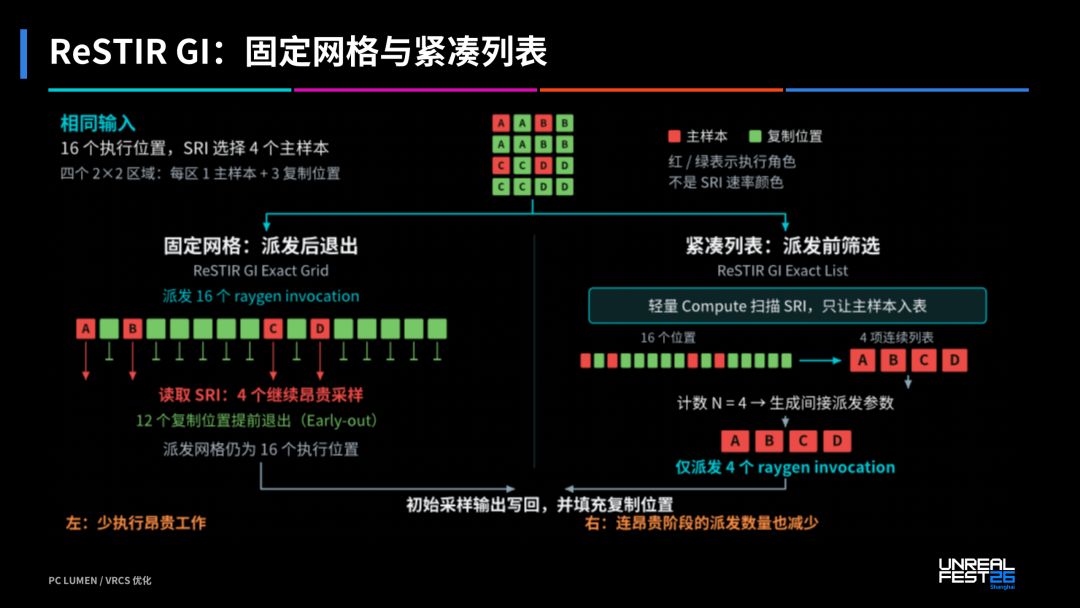
对于基于任务列表的间接分发的Compute Pass,比如基于光线列表的光追Pass,在生成光线列表时就可以把副像素直接筛掉,例如16个候选只留4个主像素进去,后面软件追踪的线程数、硬件光追的调度规模都跟着缩。实测下来,比让多余线程自己退出更划算。
在三种不同的Lumen 光照配置下,这种思路都能有效地帮助项目减少工作,提高帧率,高负载模式下提升达到20%~30+%。
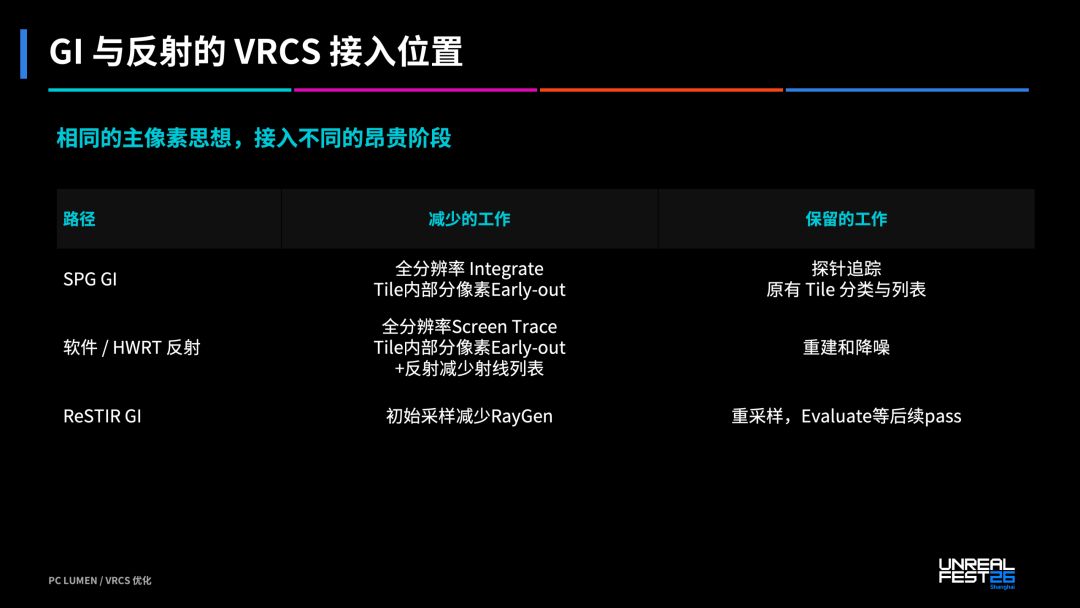
总结下来,《异环》的VRCS优化将硬件的条件分辨率应用在计算与光追流程,通过结合空域对比度与时域收敛稳定性,为高负载的 Lumen 全局光照与反射效果争取到了可观的性能提升
03
结语
大世界游戏品类,是目前国产游戏对内容资源品质要求最高的赛道之一,同时也有着相当大的用户盘子。
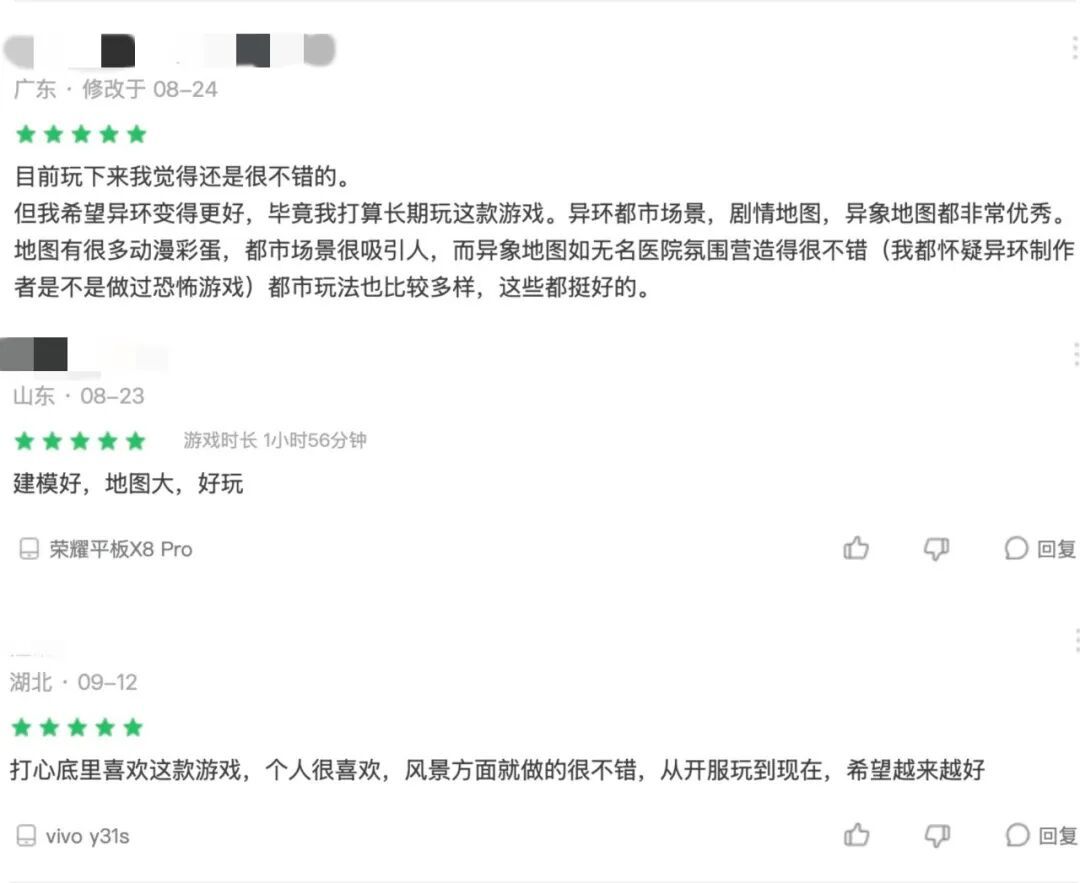
在好游快爆上,有不少玩家表示,优秀的画面表现是让他们喜欢《异环》的原因之一,无论在收集还是PC上,推门即入的店铺和热闹的街景都让他们喜爱。而在这些画面背后,玩家感受不到的,是工程团队在台后为每一毫秒的取舍。
纵观整场演讲,《异环》无论是在CPU端做无缝加载与NPC限额,还是在GPU端做双平台Lumen,其实一直在回答同一个问题:在一帧固定的时间里,哪些事必须立刻做,哪些事可以攒到下一帧做,哪些事可以直接不做。或许也只有把账算到这种颗粒度,才能撑起玩家眼里那个「理所当然」的无缝都市,在如今激烈的市场竞争中,争取到更多用户。
01:20
能联机的国产刷宝肉鸽!手游端10月22日首发上线!
超2000w玩家的失落城堡续作,10月22日手游端首发上线!200+武器、140+宝藏自由组合,最多支持4人联机开黑!#失落城堡2
@趣游挖掘机
1 赞
5 回复
今日官宣用户破亿:代表端游复苏的腾讯大作,彻底浮出了水面
等得起。
文/大田&严锦彦
今天,《无畏契约》(玩家社区俗称「瓦」)官方公布端游国服注册用户数突破1亿。
如果你这些年关注端游,应该更能感受到这个数字的含金量。
端游从注册到实际体验的链路比手游长得多,获取新用户的成本也更高。在移动端占据主导的当下,《Apex英雄》《守望先锋》《彩虹六号:围攻》等端游的破亿成绩,大多依靠全球用户,平台包括PC和主机,并积累了多年;更别说,这些作品其实发布距
@游戏葡萄
爆冷登上畅销榜Top4:2026最鸡贼的新游,把两个品类都干沉默了
看好了,二次元是这样用的!
文/九莲宝灯
开服三天后,灵犀的《篮球少女:飞跃巅峰》登上了App Store游戏畅销榜第4。
这成绩让不少人意外。毕竟在开服前,《篮球少女》就遭受了不少质疑。
一来,很多人认为把二次元和篮球粉丝凑一块简直是两头不讨好。「到底是想吸引谁」的疑问一直悬在这款游戏头上。
二来,《篮球少女》背后的灵犀,不论在体育还是二次元赛道,都没有什么太深的资历。何况今年二游的竞争何其激烈
@游戏葡萄
《宝可梦大集结》官宣将停运,世界第一IP也做不好MOBA?
IP影响力≠商业成绩。
文/以撒
今天下午,宝可梦官方宣布,《Pokémon UNITE》预计于 2027 年 3 月停运。自 2021 年 7 月在 Nintendo Switch 上线以来,其运营时间约为 5 年 8 个月。公告同时确认,Switch 与手机版本将停止服务。
上下滑动查看
游戏的国服版本《宝可梦大集结》紧随其后,同样发出了停运公告,宣布将于 2027 年 1 月停运。这款游戏,
@游戏葡萄
01:04
官方授权外挂?一枪一个小盆友,这谁顶得住啊!!
透视+锁头+无限子弹=处决模拟器!
这游戏内置外挂,真够意思啊,
玩着真是爽歪歪,快要让我把持不住了!
#射击游戏 #第一人称 #游戏推荐 #游戏安利 #发现好游戏
@大屋无武物
18 赞
4 回复
01:10
幸运房东+人生模拟?!你能活出什么样的人生?
#宝藏游戏安利派对 #人生棋局 #游戏安利 #游戏讨论 #游戏推荐 #人生模拟 #幸运房东 #TapTap聚光灯独立游戏
@栖迟
8 赞
3 回复
01:04
今晚卖麻糍🍪亲自动手包麻糍,四种主馅、八种小料和种外层
#宝藏游戏安利派对 #发现好游戏 #游戏安利 #游戏推荐 #治愈系游戏
@月亮满了
13 赞
2 回复
01:38
变成猫咪两眼一睁就是拆家!别被铲屎官的平底锅制裁
#我是猫 #发现好游戏 #猫咪模拟器 #steam移植
@爱吃香菜
20 赞
6 回复
01:01
堪比环世界+远行星号的结合!场面宏伟,游戏机制多样!
#游戏冒险家大集结 #游戏安利 #游戏推荐
@云云不昀
6 赞
1 回复
01:17
正常肉鸽选职业,这游戏直接让我把职业玩坏
#游戏冒险家大集结 #像素 #竖屏 #肉鸽游戏 #游戏推荐
@不想思考的索子
5 赞
1 回复