
下载 App
【我和老祖宗的一天】开发者日志-04
AI是否能成为人类的“道德法官”?
开一篇世界观专题日记
嘴上说着简单点,简单点好啊,又是忍不住源源不断补充世界观和完善人设(实际大部分根本不会作用于游戏)以前就爱干这事,有了高级版搜索引擎(AI)横空出世后,更是沉迷其中()
虽然,它们依旧经常会信誓旦旦说出完全错误的答案x
关于老祖宗
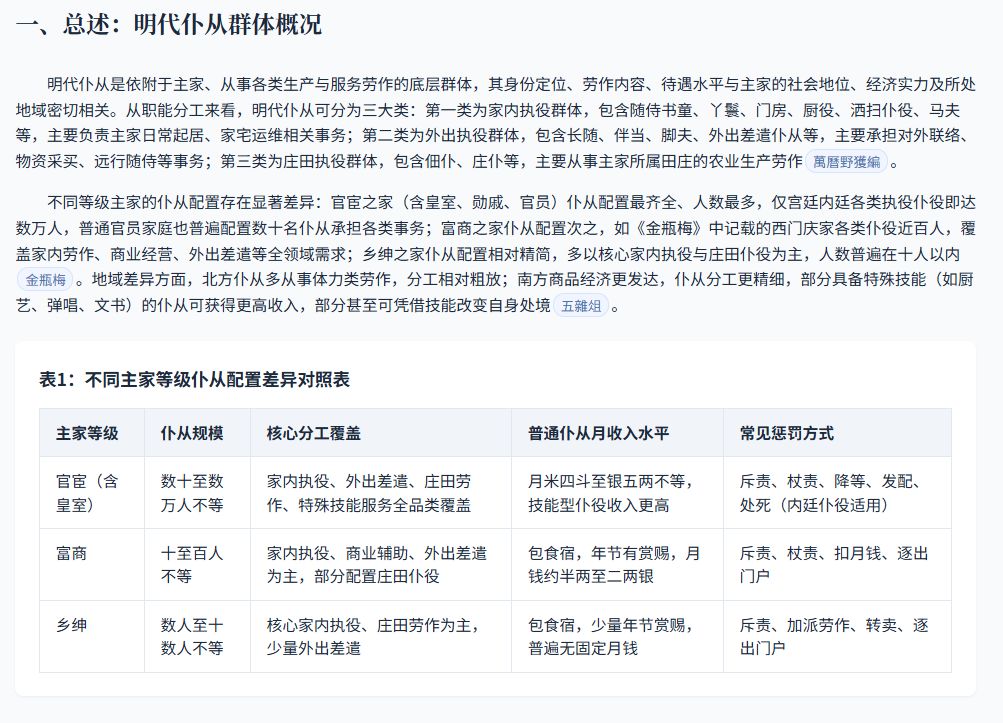
原先古代主角原型其实是米芾,后续经过考量调整设定,沿用了是史料记载里的一名(无名无姓)家童,甚至连他的主人我都找不到更多信息。借助识典古籍深度助手,去考据还原古代家童完整的二十四小时日常。
如果有感兴趣的(有吗?)可前往传送门:识典古籍
如果有感兴趣的(有吗?)可前往传送门:识典古籍
每日灵魂发问:你用到文案中了吗?
原本考虑古今两位主角使用完全相同的名字,但比较怀疑AI现在的分辨能力,如果每次都要写提示词、配置剧情分支,后续维护也容易出现人为失误和麻烦。最终决定,二人采用同音不同字的命名方式。
关于现代人
既然G老师创作出了女主,我也就沿用了这个性别设定, 现代故事的核心引子,取材于身边朋友真实发生的一件事:朋友外出时丢失 U 盘,从我的住处长途折返回家,沿途途经很多地点,一路寻找。只是故事作为基点,角色外貌和性格和这位朋友没有任何关联。 关于人设,其实只要是人类,创造所谓的普通人,总是带有色彩的。为了避免这种多样的色彩和主观的代入,甚至连她的性格和外貌,都是让AI自己去生成它理解的《一般人》。
关于善恶积分评选团
AI出现的另一个好处来了,没有任何伦理道德哲学家敢说,我能去制定一套善恶评判标准,但是AI可以。虽然它有自己的文化烙印,且从数理逻辑的角度来看,任何足够复杂的逻辑系统都存在无法被系统自身证明的“盲区”。这意味着,无论AI多么先进,它都无法在自身的算法框架内证明所有的道德真理巴拉巴拉。但其设置的数值加减,肯定是比我一个普通人瞎写来的更全面。
我先是简单说了下自己的想法,然后安排五个AI各自担任善恶积分审计师,分别独立编写善恶加减分参照表。收集完五份初稿后,又创建并且召唤了虚拟专家团完成校验整合,产出最终的善恶积分条例,根据玩家在剧情里的不同选择,驱动分数产生变动。
专家团由五个方向构成:
基础理论编审:参考康德、亚里士多德、美德伦理学、斯坎伦契约论、尼采相关思想;
核心漏洞修复:梳理规则,修补评判逻辑里的矛盾与漏洞;
现实效应校正:从环境伦理、消费伦理、行为经济学角度校正评判结果;
时空公平校正:依托中西方伦理史学,兼顾不同时代背景下的道德差异;
程序合规校验:参考罗尔斯、斯坎伦的正义理论以及现实法规做底线把控。
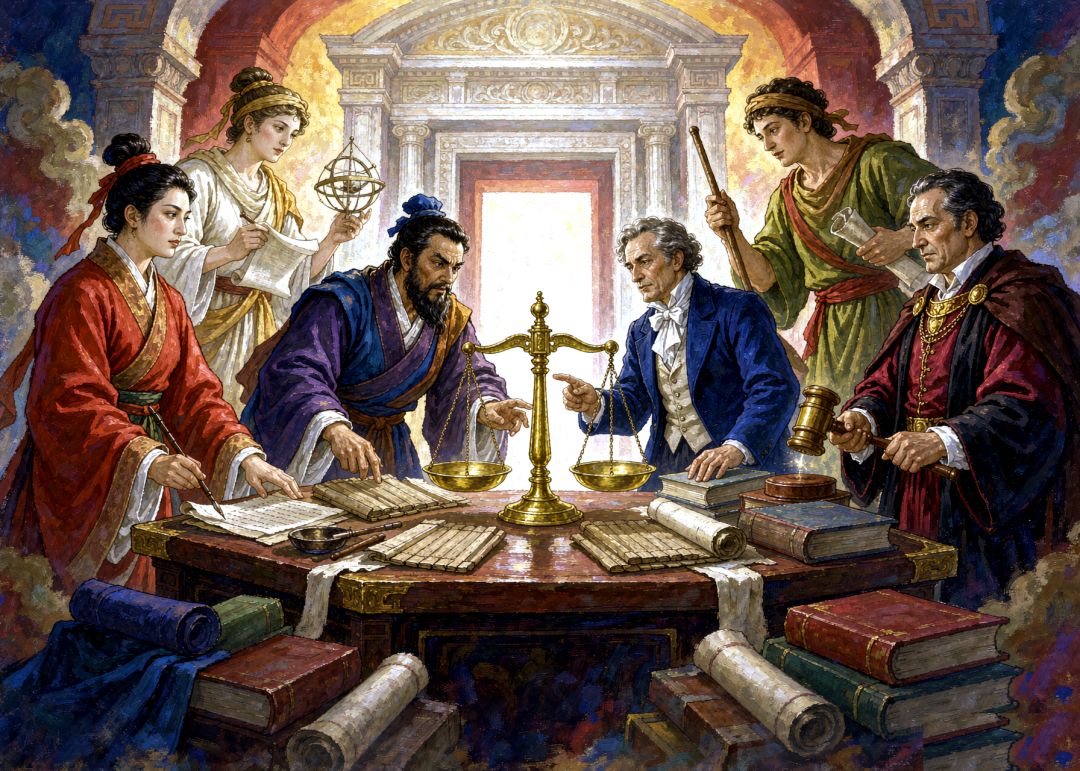
也就是本期cover上的六位主编:班昭执笔、希帕提娅持星盘、韩非指点竹简法条、斯密拢袖旁观、希罗多德背负行囊与卷轴、贝卡里亚按锤端坐
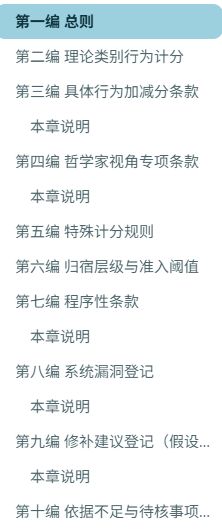
嘿,我们生成了一份(无用的)道德伦理行为积分准则
ps昨天太困了,还没写完开发日志,躺床上就是昏迷了十个小时,睡眠质量超好,闹钟都叫不醒的那种
今天还是早点写,以上有让AI总结我的口述日记部分(当然也有可能看见我古法手打的错别字✖)
【我和老祖宗的一天】开发者日志-05
肯定不是最后一篇日志
上传了
每天要的AI产出太多太多了,还有一大堆看似严谨的瞎话,如果不认真看,AI真的非常容易作妖
昨天晚上终于开始上传了!
好消息是自己实机测试还是适配屏幕的,但具体机型还没完全测过
约莫是工坊的缘故,审核其实超快,甚至还有快速审核,就是因为没找到哪里开放试玩被耽搁了x
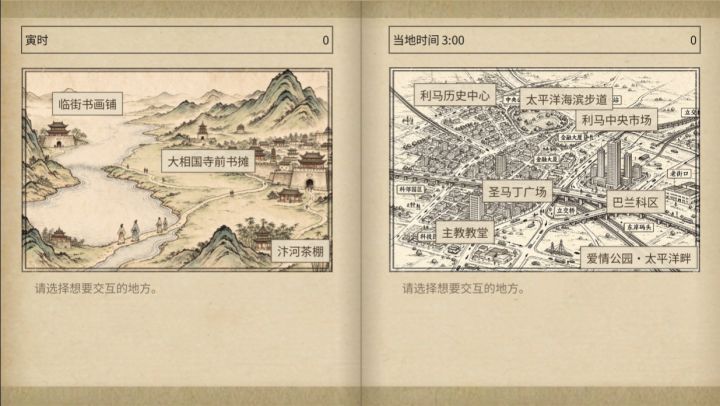
目前demo只是展示了一个概念和玩法(玩法简单到我好像不用特地去弄个教程视频),剧情又超出想象的文本量很大
官方
@gentei
4 赞
【我和老祖宗的一天】开发者日志-03
今日口头禅:若存在疑问,请先与我确认,再输出提示词
#聚光灯gamejam开发者日志
前言
看似做了很多,其实什么都没做,明天要完成文本数据全测试和scene更换(本来以为来得及自己画,现在看来绝无可能),弄完就能上传了,希望来得及。已无力手搓日记,基本让ai总结来着。 适配各端因为预览看上去还是很奇怪,字号什么都是根据我目前预览效果更改的。暂时不管了,实机测试的时候再改。
一、核心系统重构(剧
@gentei
4 赞
【我和老祖宗的一天】开发者日志-02
Vibe Coding大抵是个放置类MUD游戏,内含氪金抽卡
涌错地方了
这段时间主线还是《我和老祖宗的一天》,但中途做了一个秘鲁旅游小游戏支线,也算是我第一款完成的Vibe Coding小游戏(虽然帖子被不明原因隐藏了,约等于白做)本预计一天完成,结果出不了效果,死磕了好几天,多少有些浪费,等出效果的贤者时间里思索:我究竟是在创作,还只是单纯在玩一款模拟老板的游戏?
从小游戏摸出一套思路就是(然
@gentei
4 赞
【我和老祖宗的一天】开发者日志-01
在一切还悬而未决之际,开发日志就如同许愿日记
絮絮叨叨的前言
我做一件事,容易花费23小时不断进行先行研究,完善概念,修改方案,想法无休止的涌现在脑海,最后花1个小时开始动手,结果可想而知……所以这次我决定:选取第一个涌现出来想法!
就这样在看到开发主题的同时,我的核心主题立马确定了。脑海里演算好几个玩法版本后,不完美,但可行。随后我也和ai组员们展开了讨论,实际推进中,组员们纷纷指出了容易翻车的
@gentei
8 赞
1 回复