
下载 App



小创新如何杀死长期项目:不同视角下的开发权重与上下文治理
3 小时前22 浏览综合 包含 AI 合成内容
序章:一个停摆项目引出的行业问题
咕咕这边有超过8个项目处于停摆和快要放弃的阶段。
它们中的大多数是长期项目,中型游戏。策划文档写了很多,不是没想法,不是没热情,恰恰相反——每停摆一个,咕咕都能翻出厚厚一叠设计草稿,有些甚至已经跑出了可玩的原型。程序那边也在往前推,策划那边也在往前推,但推着推着,进度就卡住了。卡在一个很小的地方:程序觉得加一个手感反馈会更好,加完之后发现要调数值,调完数值发现策划的叙事节奏被打断了,策划回头改叙事,改着改着又冒出一个新的小巧思——然后整个链条重新走一遍。
这不是一个团队的问题。咕咕后来确认了一件事:就算是一个人开发,也会经历完全一样的困境。只是团队会放大混乱,单人会放大孤独感。病根是一样的。
于是问题变成了:为什么一个小巧思,能让整个游戏停摆?
如果只是咕咕一个人的问题,那这篇文章就不值得写。但咕咕越往里挖,越发现这件事不孤单。海外游戏服务公司SuperScale向504家手游公司发起了一次问卷调查,数据摆在面前:43%的游戏还未上线就被取消,83%的手游项目在三年内死亡,47%的项目在上线12个月内就已经死亡。接近一半的项目,连和玩家见面的机会都没有。更让咕咕在意的是另一组数字:76%的项目营收峰值出现在第一年,仅有4%的游戏在第二年创下营收新高。这意味着一个项目如果在早期没能建立足够的吸引力,后面几乎不会翻盘。
但这些数据只是结果。咕咕想知道的是原因。一项对游戏开发事后复盘(postmortem)的系统性调查给出了一个直接的回答。Petrillo等人在2009年发表的研究《What went wrong? A survey of problems in game development》中,通过对大量游戏开发事后复盘的分析发现:不切实际的范围、功能蔓延和功能削减,是游戏开发中出现频率最高的问题。另一项对游戏开发事后复盘的大规模分析更直白地指出,内部问题——管理、规划、范围——比其他类别的问题高出300%。
游戏开发的失败,首先不是技术问题。是范围问题。是规划问题。是那些“看起来很小、做起来很大”的小创新问题。
Bent Flyvbjerg在《BIG THINGS》中汇总了超过16,000个大型项目的数据库,结论用三个数字就可以概括:47.9%的项目按时交付,8.5%的项目按时且按预算交付,只有0.5%的项目按时、按预算且实现了预期收益。Flyvbjerg的原话是:“你不应该期待它们会顺利,你应该期待相当大比例的项目会灾难性地失败”。
咕咕的8个项目停摆,放在这个坐标系里看,不是意外,是规律。问题不在于咕咕运气不好,问题在于咕咕一直在用“做加法”的方式做长期项目,而长期项目的底层逻辑是“做减法”。
这篇文章要回答的就是这个问题。不是回答“为什么咕咕的项目停摆了”,而是回答:为什么“小创新打断进程”是一个有数据支撑的系统性风险,而不是个人的偶然失误;以及,为什么“上下文治理”这个从AI工程领域生长出来的概念,恰好是游戏开发全流程的一把钥匙。
在展开之前,咕咕需要交代这篇文章的方法论。它不是一篇纯学术论文,也不是一篇纯个人随想。它试图做一件事:把咕咕的一手经验——8个停摆项目的真实记录、与程序/策划朋友的对话、使用AI辅助开发时的提示词错乱经历——与行业数据和学术研究放在同一张桌子上,让它们互相验证。如果咕咕的经验能和行业数据对上,那它就不只是咕咕的经验,而是一个可复现的模式。如果对不上,咕咕也会如实写出来。
第一章 正题:小创新的生产力悖论
小创新是好东西。这句话咕咕必须先说清楚,不然后面所有的分析都会变成对创意的否定,而咕咕从来没有这个意思。
咕咕做第一个叙事游戏的时候,最快乐的时刻恰恰来自小创新。某个画面构图在脑子里突然成型,某个对话节奏突然找到了正确的呼吸,某个系统机制突然和叙事主题产生了共振——那些瞬间让咕咕觉得,做游戏这件事值得熬下去。小创新是差异化、记忆点、破圈可能性的来源。没有小创新,项目会变成流水线产品,会在商店页面的海洋里无声地沉没。
但小创新有一个咕咕花了很长时间才看清的悖论:它在局部是生产力,在全局是破坏力。
这个悖论的第一层,可以用一个具体的场景来说明。咕咕有一个项目,策划文档写了大概3万字,世界观、角色、主线、支线系统都铺得很完整。程序朋友接手之后,前两周推进得很顺利,到了第三周,程序说:“咕咕,这个战斗反馈如果加一个镜头震动,手感会好很多。”咕咕说好。加完镜头震动,发现打击音的延迟需要重新调,调完延迟发现某些技能的帧数窗口要改,改完帧数窗口发现策划原本设计的一个连招逻辑和新的手感不兼容。策划朋友说:“那我把连招改一下。”改完之后,策划说:“既然连招变了,这个角色的成长曲线可能也要重新想一下。”
然后整个项目卡在了这里。
不是因为任何一个人做错了什么。程序没有错,他确实在提升体验。策划没有错,她确实在维护系统一致性。咕咕也没有错,咕咕只是说了“好”。但四个人(或者一个人在不同角色之间切换)都在做局部最优的决策,加起来就是一个全局的最差解。
这就是小创新的生产力悖论:每一个小创新单独看都是合理的,但它们的累积效应是毁灭性的。
行业数据印证了这一点。一篇基于大量失败独立游戏的复盘分析指出,超过70%的受访独立开发者承认“范围太大”是项目未能按时完成或被放弃的重要因素。咕咕看到这个数字的时候,第一反应是“原来不止我一个人”。第二反应是“70%这个数字可能还偏低了”,因为很多开发者在事后复盘时倾向于把问题归因于外部因素,而不是承认自己的范围管理失误。
Petrillo等人的研究进一步细化了这个问题。他们发现,游戏开发中最常见的问题不是孤立的“功能太多”或“时间不够”,而是一个恶性循环:开发者定义了一个过大的范围,时间和预算限制迫使他们削减功能,而削减的过程本身又产生了新的问题——已经做了一半的系统需要重构,依赖被削减功能的模块需要重新设计,团队的士气受到打击。这个循环一旦启动,就很难从内部打破。
咕咕觉得这个循环有一个更精确的名字:上下文污染。
这个概念咕咕是从AI工程领域借来的,后面会详细展开。但在这里,咕咕先用它来描述游戏开发中的一个现象:当项目上下文中的元素——目标、约束、已做决策、未做决策——开始互相矛盾或失去优先级时,整个开发进程就会失去方向。 程序加镜头震动的决策,污染了策划的连招逻辑上下文;策划改连招的决策,污染了角色成长曲线的上下文;角色成长曲线的改动,又反过来污染了程序最初做的手感调优的上下文。每个决策都在合理地回应前一个决策,但没有任何一个决策在回应项目的整体目标。
用一个行业案例来对照。黑曜石娱乐的《永恒之柱》(Pillars of Eternity)在Kickstarter众筹时承诺了一个极其庞大的范围:广阔的分支叙事、多个可玩职业、精细的角色定制系统。最终发售的版本是一个“显著缩减版”。游戏本身获得了不错的口碑,但一些众筹支持者感到被辜负了。黑曜石后来在续作《永恒之柱II:亡焰》中调整了范围策略,但那是另一个故事了。咕咕从这个案例里看到的不是“众筹有风险”,而是一个更朴素的事实:即使是经验丰富的开发团队,也会在范围面前失去控制。 区别只在于,他们有人帮忙踩刹车,而咕咕是一个人开车,没人踩刹车。
那么,小创新到底应该被怎么对待?
咕咕现在给出的回答还很不成熟,但它是一个方向:小创新需要被治理,而不是被消灭。 治理的方式不是“禁止加东西”,而是“给每一个小创新一个明确的上下文位置”。如果一个小创新服务于当前阶段的开发权重,它就是生产力;如果它不服务于当前权重,无论它看起来多好,它都是进程杀手。
Bent Flyvbjerg的研究中有一个咕咕反复回味的发现:许多项目之所以延期,是因为“没有花足够的时间做规划”——而规划是缩小风险最有效的方式。他没有说“不要有创意”,他说的是“在动手挖之前,先知道自己在挖什么”。这句话对咕咕的冲击很大。咕咕的8个停摆项目里,有多少个是在“知道自己在挖什么”之前就开始挖了?
咕咕不想在这里给出一个过于漂亮的答案。因为咕咕自己也没有完全做到。但咕咕至少可以诚实地描述那个悖论:小创新是咕咕做游戏的动力,也是咕咕项目停摆的原因。 这两件事同时为真。承认这一点,是后面所有分析的前提。
第二章 反题:没有小创新,项目也会死
上一章结束时,咕咕留了一个假设:小创新不是进程杀手,未经上下文治理的小创新才是。这一章要做的,是把假设反过来——如果没有小创新,如果咕咕把所有小巧思全部压制,只做“安全”的东西,8个项目会不会至少有一些能活下来?
咕咕的直觉是不会。但直觉需要论证。
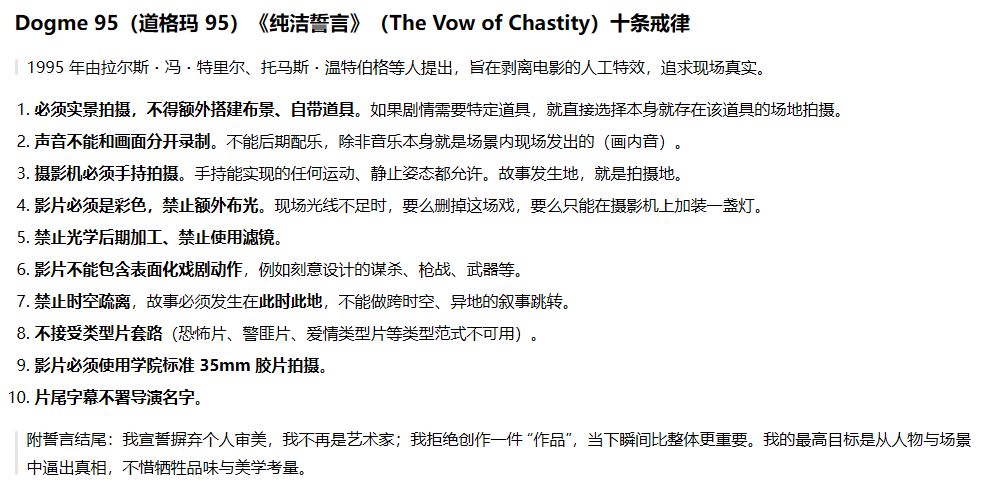
先从一个反直觉的研究说起。游戏开发领域的学术文献中,有一个被反复讨论但很少被从业者阅读的发现:形式约束不仅是创造力的限制,更是创造力的燃料。 Lai和Vecchi在2024年发表于《Games and Culture》的论文中,考察了游戏Jam、Dogma ’95电影运动、Demo Scene、OuBaPo漫画写作团体和日本连歌诗人五个看似无关的创作传统,发现它们共享一个底层机制——通过施加形式约束来激发创造力并引导创作过程。游戏Jam的规则“48小时、一个主题、从零开始”不是创意的敌人,而是创意的引擎。Dogma ’95要求导演“不使用人工灯光、不添加配乐、不进行后期调色”,结果催生了拉斯·冯·提尔和托马斯·温特伯格最具标志性的作品。
这个发现对咕咕的冲击在于:它把“约束”从负面词汇翻转成了正面词汇。 但咕咕需要小心,不能从一个极端滑到另一个极端。形式约束之所以能激发创造力,前提是它是被设计过的约束——Jam的48小时限制是组织者设计的,Dogma ’95的十条戒律是导演们自己约定的。它们和“项目做到一半程序突然加一个镜头震动”有本质区别:前者是前置的、集体同意的规则,后者是后置的、单方面的变更。
所以更精确的表述是:好的约束是创造力的一部分,坏的约束是创造力的杀手。 而“坏”的定义不是“约束本身不好”,而是“约束没有经过治理”。
Aalto大学的Feijoo Melián和Kultima在2026年的论文中做了一个更贴近咕咕经验的实验。他们把游戏开发中的deadline——通常被从业者视为“必要之恶”、与crunch和创意妥协联系在一起的东西——重新框定为一种开发工具。研究发现,deadline的作用方式“类似于游戏规则,创造了一个‘开发魔法圈’(Development Magic Circle)”。在这个圈子里,开发者知道自己必须做什么、不能做什么,反而更容易进入创造性的状态。相反,如果没有任何deadline,没有范围边界,开发会陷入一种“无限的可能性”带来的瘫痪——咕咕对此太熟悉了。8个停摆项目里,至少有三个不是因为做不完,而是因为“不知道做什么是对的”。
现在咕咕需要把这个洞察和行业数据连接起来。SuperScale的数据显示,83%的手游项目在三年内死亡。Petrillo等人的研究发现,不切实际的范围、功能蔓延和功能削减是游戏开发中出现频率最高的问题。把这些数据和上面的研究放在一起,一个更完整的图景浮现出来:
大量游戏项目不是死于“没有创意”,而是死于“创意没有边界”。 但“有边界”不等于“没有创意”。恰恰相反,有边界的创意——经过形式约束、deadline、开发权重治理的创意——才是可持续的创意。
咕咕在自己的项目里验证过这个结论。有一个项目,咕咕在早期刻意压制了所有“不服务于核心循环”的小巧思,只做了最基础的系统。项目确实活下来了,推进到了可玩原型阶段。但咕咕很快就发现了一个新的问题:这个原型没有任何让咕咕想继续做下去的冲动。 它“安全”,但它不“活着”。咕咕在设计文档里翻了一遍,找不到任何一个可以让咕咕兴奋到熬夜调参数的设计点。项目最终没有被放弃,但它进入了一种比放弃更糟糕的状态——冷启动失败。咕咕每天打开工程文件,做完当天的任务,关掉,第二天再打开,做完,关掉。没有任何一个瞬间让咕咕觉得“这个东西值得做完”。
这不是咕咕一个人的经验。独立游戏开发社区中有一个被反复讨论的现象:“垂直切片困境” ——开发者做了一个技术上完整、功能上可玩的垂直切片,但切片本身没有任何“钩子”。它证明了“这件事能做成”,但没有证明“这件事值得做成”。而“值得做成”的感觉,往往来自那些看起来很小、但能改变整个体验质感的小创新。
所以反题的完整论证是:压制小创新不会让项目活下来,只会让项目死于另一种死法——不是死于进程卡死,而是死于意义耗尽。
但这个论证需要被辩证地看待。咕咕不是说“所以应该放开小创新”,咕咕说的是:小创新的问题从来不在小创新本身,而在于它有没有被放置在一个能被管理的位置上。 Jam的48小时限制管理了小创新——它允许小创新,但把它压缩在时间和空间的边界内。Dogma ’95的十条戒律管理了小创新——它禁止某些东西,但恰恰因此迫使导演在剩下的维度上创新。开发权重管理的正是同一件事:不是禁止小创新,而是给每一个小创新一个明确的上下文位置。
到这里,正题和反题碰在了一起。正题说:小创新是进程杀手。反题说:没有小创新,项目死于意义耗尽。两者的合题不是“折中”——不是“适量的小创新”——而是一个更精确的命题:
小创新需要一个治理系统,让它在正确的时间、以正确的粒度、进入正确的上下文。
这个治理系统,咕咕把它叫做上下文治理。
而咕咕之所以用“上下文”这个词,而不是“范围管理”或“优先级排序”,是因为咕咕在8个停摆项目中最深的教训,恰恰来自AI辅助开发时的上下文混乱。那个教训让咕咕意识到:游戏开发的问题和AI协作的问题,在底层是同构的。
第三章 合题:上下文治理——从AI工程到游戏开发的跨域迁移
咕咕第一次意识到“上下文”是一个可以独立于AI来讨论的概念,是在一个非常具体的时刻。咕咕在用AI辅助写一个系统的数值平衡逻辑,提示词里包含了这个系统的设计文档、已有的代码结构、之前几轮对话中确认的约束条件。前几轮对话进行得很顺利,AI生成的代码基本符合预期。到了第七轮或第八轮,咕咕加了一条新的约束:“这个系统的所有伤害计算必须走统一管线,不能有例外。”AI回复了一段代码,看起来满足了这条约束。咕咕继续往下推进。又过了几轮,咕咕发现AI生成的代码里出现了一个绕过管线的伤害计算逻辑。咕咕回头看,发现是在某一轮对话中,AI为了“优化性能”而“临时”绕开了管线。那个临时决策进入了上下文,被后续轮次反复引用,最终变成了一个咕咕从未批准过的架构决策。
这是一个教科书级别的上下文中毒——错误或幻觉信息进入上下文并被反复引用,导致模型围绕虚假信息形成策略。但咕咕当时并不知道这个术语。咕咕只知道一件事:咕咕在AI协作中犯的错误,和咕咕在游戏开发中犯的错误,是同一个错误。
那个错误的名字是:没有管理好“什么信息应该被当作决策依据”。
四种上下文失效模式,和咕咕的8个项目
Drew Breunig在2025年系统性地总结了长上下文的四种失效模式,后来被LangChain和Anthropic等机构广泛引用和扩展。咕咕第一次读到这个框架时,几乎是条件反射地把每一个模式翻译成了自己的项目经历:
上下文中毒。 错误或幻觉信息进入上下文并被反复引用。咕咕的一个项目里,策划在早期写了一句“这个角色的核心机制是资源消耗”,但那只是众多可能性之一。程序读到这句话,把它当成了确定的设计决策,围绕“资源消耗”搭建了整套数值框架。等到策划回头想要调整这个机制时,发现代码已经深度耦合,改动的成本远远超过了策划当初写下那句话时的预期。那个早期的不确定假设,变成了事实上的决策基础。 咕咕后来在项目复盘里写:这不是策划的错,也不是程序的错,是那个假设没有在一个可以被质疑的位置上。
上下文分心。 上下文过长,模型过度依赖历史数据而非训练知识。Databricks的测试显示,Llama 3.1 405B在约32,000 token后正确率开始显著下降。在咕咕的项目里,这个模式的对应物是“历史债务压过当前判断” 。一个项目做到中期,咕咕发现自己做决策时越来越频繁地参考“之前是怎么做的”,而不是“现在什么是对的”。之前的决策堆积在咕咕的脑子里,形成了某种惯性。咕咕在调一个战斗系统的数值时,发现自己在用“和之前那版差不多”的标准,而不是“这一版的目标是什么”的标准。上下文太长,咕咕失去了重新思考的能力。
上下文混淆。 无关或冗余信息干扰生成。伯克利函数调用排行榜的数据显示,提供给模型的工具数量从19个增加到46个时,压缩版Llama 3.1的表现反而下降,模型会强行调用无关工具。咕咕的项目里,这个模式的表现是:决策空间过大导致的决策瘫痪。 一个长期项目在中期有太多的“可以做”——可以做的新系统、可以改的旧系统、可以加的内容、可以优化的性能——它们同时挤在咕咕的注意力里,每一个都看起来有理由做。咕咕的8个停摆项目中,有至少两个的直接死因是“不知道下一步做什么”,而不是“做不完”。
上下文冲突。 新旧信息或工具描述存在矛盾,导致推理失败。微软和Salesforce的研究发现,拆分提示信息并逐步提供会导致表现下降39%。咕咕的项目里,这个模式的对应物是最直接也最痛苦的:策划的叙事上下文和程序的系统上下文互相矛盾。 策划说“这个角色的成长应该服务于叙事弧线”,程序说“这个角色的成长应该服务于数值曲线”。两个上下文各自自洽,但放在一起就不自洽。而咕咕没有能力(或者说没有意识)把这两个上下文分开管理,结果就是它们在一个共享的决策空间里互相打架,直到项目停摆。
上下文隔离:一个已经被验证的解决方案
理解了问题之后,解决方案的方向就变得清晰了。上下文工程的实践中,应对上述四种失效模式的核心策略之一是上下文隔离——将不同的关注点分布到独立的上下文窗口中,避免相互污染。
Anthropic的多Agent研究系统提供了一个有数据支撑的案例。在他们的内部研究评估中,具有隔离上下文的多代理架构相比单代理系统,性能提升了90.2%。原因不是“更多Agent更聪明”,而是每个子代理的上下文窗口被分配给了更窄的子任务。一个子代理负责搜索,一个负责验证,一个负责综合——每个代理的上下文里只有它需要的信息,没有其他任务的噪声。
咕咕读到这个数据时的第一反应不是“AI真厉害”,而是“这不就是咕咕一直想做但没做到的事情吗”。咕咕的策划朋友和程序朋友,本质上就是两个子代理。策划的上下文里应该只有叙事、角色、世界观、情感节奏。程序的上下文里应该只有系统、数值、性能、架构。但咕咕的8个项目里,这两个上下文从来没有被真正隔离过。它们共享同一份设计文档、同一个聊天群、同一轮对话——然后互相污染。
上下文隔离不是“让策划和程序不说话”。 隔离解决的是“信息怎么进来”的问题。他们需要通过共享的约束文档来对齐,但他们不应该共享同一个决策空间。策划决定“这个角色的成长弧线是什么”,程序决定“这个成长弧线用什么数值曲线来实现”。这两个决策的上下文不同,混在一起就会互相干扰。
咕咕后来在AI辅助开发中尝试了一个具体的做法:给策划任务和程序任务分别开不同的对话线程。 策划线程的上下文里只有叙事文档、角色设定、情感节奏参考。程序线程的上下文里只有系统架构、数值框架、性能约束。两个线程共享同一份约束词/对照词文档——那份文档规定了“什么是不能变的”(比如“主角的成长必须经历三次失去”),但不规定“怎么实现”。这个做法没有解决所有问题,但它让咕咕第一次感受到了上下文干净带来的决策稳定性。程序线程不会再因为看到策划的叙事草稿而“顺手”改一个数值曲线,策划线程不会再因为看到程序的架构限制而“顺手”砍掉一个情感节点。
从AI协作回到游戏开发:约束文档作为治理基线
咕咕现在回到咕咕最初的困境:8个停摆项目,大多死于小创新打断进程、开发到一半不知道下一步、策划和程序互相改道、AI提示词混乱。
把这些症状和上面的分析对照,咕咕看到了一个统一的病因:这些项目缺少一份可以被所有上下文引用的“约束文档”。(实际上是这个约束文档 经常变动,导致上下文更新不及时)
约束文档不是设计文档。设计文档描述“做什么”,约束文档描述“什么不能变”。设计文档可以很长、可以不确定、可以充满“也许”和“可能”。约束文档必须很短、必须确定、必须每一条都是“是”或“否”。
咕咕设想中的约束文档至少包含三层:
第一层:项目级约束。 这个项目的核心体验是什么?一句话。这个项目服务的玩家是谁?一句话。这个项目在什么情况下应该被放弃?一句话。这三个问题必须在任何小创新被接受之前就有答案。咕咕的一个停摆项目,如果咕咕在第一天就写下了“这个项目的核心体验是‘在有限资源下做出有代价的选择’”,那么程序后来加的那个“无代价的镜头震动”就会被约束文档挡住——不是因为它不好,而是因为它不服务于核心体验。
第二层:模块级约束。 每个系统模块的“不可协商项”是什么?战斗系统的不可协商项可能是“所有伤害必须走统一管线”。叙事系统的不可协商项可能是“主角的每个关键决策必须有情感代价”。这些约束不是设计细节,是架构级别的承诺。它们一旦被违反,系统就会失去一致性。
第三层:上下文隔离规则。 哪些决策在哪个上下文里做?策划上下文做叙事决策,程序上下文做实现决策,数值上下文做平衡决策。每个上下文有自己的输入(哪些文档可以被引用)和输出(哪些决策可以被提交)。上下文之间的接口是约束文档,不是自由对话。
咕咕知道这个框架听起来很“工程化”,甚至可能让一些创作者觉得不舒服。咕咕自己也有过这个感觉。但咕咕现在认为,不舒服的感觉恰恰说明它触到了要害。 咕咕的8个停摆项目,没有一个是因为“太工程化”而死的。它们全部死于决策没有被治理。
一个被验证的先例:腾讯游戏的上下文工程实践
咕咕在写这一章的时候,恰好看到腾讯游戏技术专家杨梦舟在一篇分享中提出的框架。他把AI在游戏开发中的应用分成了三个阶段:Prompt Engineering(把话说清楚)、Context Engineering(把背景给完整)、Harness Engineering(把AI放进可控流程) 。咕咕读到这里时有一种被确认的感觉:咕咕一直在做的事情,本质上就是在Context Engineering和Harness Engineering之间摇摆。咕咕有意识地在管理上下文(做约束文档、分线程),但没有建立起完整的流程控制(谁在什么条件下可以修改约束文档、修改后如何通知所有上下文)。
这个框架让咕咕看到了下一步。上下文治理不是一个“一次性设置”,它是一个持续的过程:约束文档需要被维护,上下文隔离需要被监控,污染的上下文需要被清理,冲突的上下文需要被仲裁。咕咕的8个项目之所以停摆,不仅仅是因为“没有上下文治理”,更是因为咕咕没有意识到上下文治理是需要持续投入的。
合题的边界
咕咕需要在这一章的末尾划一条边界,不然“上下文治理”会变成一个新的万能答案,而那恰恰是咕咕想要避免的。
上下文治理能解决的是工程层面的决策一致性问题。它不能解决的是创意层面的判断问题。约束文档可以规定“主角的成长必须经历三次失去”,但它不能规定“第二次失去应该是失去什么”。上下文隔离可以让策划和程序不在同一个决策空间里互相干扰,但它不能让策划的叙事判断变得更好,也不能让程序的实现判断变得更优雅。
咕咕的8个停摆项目中,有一些项目的死因确实超出了上下文治理的范畴。有一个叙事驱动的项目,咕咕在立项时就清楚地知道核心体验是什么,约束文档也写得很清楚。但咕咕做不下去,不是因为决策混乱,是因为咕咕不知道自己想说什么。那个项目需要的不是更好的上下文治理,而是一个更诚实的自我对话。
第四章 开发权重:有方法论支撑的优先级管理
咕咕在描述了三种隔离——项目级约束、模块级约束、上下文隔离规则——但咕咕没有回答一个更具体的问题:当八个项目同时摆在面前,当每个项目里有三十个待做决策,当每个决策都看起来“应该做”的时候,怎么决定先做哪个?
这就是“开发权重”要处理的事。
咕咕在最初写这段的时候,用的词是“开发群众”,后来发现是“开发权重”的误记。但这个误记本身挺有意思——“群众”意味着数量多、声音杂、每个人都觉得自己的需求重要。开发权重的本质,就是在这一堆“群众声音”里,找到一个可以被执行的排序。
咕咕的困境是:这件事官方也在讲,但真的很难把握。难在哪?咕咕后来想清楚了——难在咕咕一直在用“体感”做决策,而不是用“方法”做决策。 咕咕翻开任何一个停摆项目的记录,都能看到类似的句子:“咕咕觉得这个应该先做”“咕咕感觉这个不做会影响体验”“咕咕直觉上觉得可以放一放”。这些判断可能对,可能错,但它们是不可复现的。今天咕咕觉得A比B重要,明天咕咕的心情变了,可能就觉得B比A重要。没有方法,就没有锚点。
四个工具,四个不同的“锚点”
咕咕后来花了很长时间去找“别人是怎么做的”。不是为了照搬,是为了知道这件事有没有已经被验证过的路径。咕咕找到了四个工具,它们各自解决不同粒度的问题。
第一个工具是ICE方法。 这是咕咕觉得最适合单人开发者和小团队的方法,因为它的结构最简单。ICE是Impact、Confidence、Ease的缩写——影响范围、自信程度、实现难易。评分级别为1到5分,三个维度分别估分,总分满分15分,评分越高的功能点优先级越高。咕咕第一次看到这个框架的时候,觉得它太朴素了,朴素到有点让人不放心。但咕咕后来意识到,朴素恰恰是它的优势。当咕咕面对三十个待做决策的时候,咕咕需要的不是精确,而是能够快速把所有决策放在同一个尺度上比较。
咕咕举一个具体的例子。有一个停摆项目的战斗系统,当时待做决策包括:A. 增加一个连招取消机制;B. 优化打击音的延迟;C. 重做技能图标;D. 增加一个战斗中的环境互动。咕咕用ICE各自打分:
- A的Impact是5(直接影响核心体验),Confidence是4(咕咕比较确定这个机制有效),Ease是2(实现难度较高),总分11。
- B的Impact是3(影响手感但不影响系统),Confidence是5(非常确定),Ease是4(实现简单),总分12。
- C的Impact是2(美术优化),Confidence是3(不确定玩家是否在意),Ease是5(实现简单),总分10。
- D的Impact是4(增加战斗多样性),Confidence是2(不确定和现有系统的兼容性),Ease是2(实现复杂),总分8。
排序结果:B(12)> A(11)> C(10)> D(8)。咕咕当时的直觉是A优先,因为“连招取消”听起来更“核心”。但ICE的排序告诉咕咕:B的优先级更高,因为它的确定性最高、成本最低,可以在最短时间内产生可感知的体验提升。 咕咕后来做了B,发现打击音延迟的优化确实立刻提升了手感,而这个手感提升又反过来让咕咕对A(连招取消)的实现有了更清晰的判断。
ICE方法有一个重要的使用前提:它主要适用于C端已经上线的成熟产品,通过ICE可以有理有据地明确迭代优先级。它不适用于产品早期,因为在早期要尽快完成PMF(产品市场匹配)以及MVP的功能,还用不上ICE。咕咕的理解是:ICE是“多个选项之间的比较工具”,不是“从零到一的决策工具”。 咕咕的8个停摆项目里,有一些死于“没有用ICE”,有一些则死于“在应该先做MVP的阶段用了ICE”。
第二个工具是Karl Wiegers的相对权重法。 如果ICE解决的是“快速排序”,相对权重法解决的就是“深度排序”。这个方法由Wiegers在1999年提出,将需求的价值从两个维度拆开:实现该功能带来的收益,以及不实现该功能招致的惩罚。每个维度用1到9打分,总价值是收益和惩罚之和。然后估算实现成本和风险,最终优先级公式为:优先级 = 价值% / (成本% × 成本权重 + 风险% × 风险权重)。
咕咕对相对权重法最感兴趣的地方,是它把“不做会怎样”放进了决策框架。咕咕之前做决策的时候,只考虑“做了会怎样”——“做这个功能会提升体验”“做这个系统会丰富玩法”。咕咕从来没有系统地想过:“如果不做这个功能,会损失什么?”相对权重法强迫咕咕回答这个问题。
咕咕用一个停摆项目的例子来说明。那个项目是一个长期运营向的中型游戏,咕咕当时纠结要不要加一个每日任务系统。用ICE打分:Impact 3(不是核心体验),Confidence 2(不确定玩家会不会做),Ease 3(实现不复杂),总分8。按ICE排序,这个功能优先级不高。
但用相对权重法重新评估:相对收益是4(丰富日常玩法),相对惩罚是7(如果不做,玩家在主线之外的日常留存会受影响),总价值11。相对成本是3(开发量不大),相对风险是2(技术风险低)。优先级 = 价值% / (成本% × 权重 + 风险% × 权重)。虽然咕咕在这里不展开完整计算,但关键在于:相对惩罚的高分改变了这个功能的排序位置。 它从“优先级不高”变成了“优先级中等偏上”。咕咕后来做了一半,发现惩罚确实存在——没有日常内容,玩家在主线结束后流失速度明显加快。
相对权重法有一个使用边界:它只应应用于可协商的功能,不包括核心业务功能、关键差异化因素或法规要求的功能,因为无论如何都要包含这些功能。咕咕把它理解为:先确定“必须做”的集合,然后用相对权重法对“可以做”的集合排序。 这个边界很重要,因为如果没有它,相对权重法会变成一个无限扩张的排序游戏,而不是一个收敛工具。
第三个工具是Kano模型。 ICE和相对权重法解决的都是“排序”问题,Kano模型解决的是“分类”问题。Kano模型将功能分为三类:基本型(没有会不满,有了也不会特别满意)、期望型(越好越满意)、兴奋型(没有不会不满,有了会惊喜)。2024年发表于《Quality Innovation Prosperity》的一篇研究将Kano模型应用于游戏敏捷开发,试图识别视频游戏中可作为功能的关键属性。研究的一个发现是:在汇总数据中,没有找到任何一维属性是游戏客户的关键属性,只识别出了有限数量的“兴奋型属性” 。
咕咕对这个发现的解读是:游戏玩家的满意度结构比一般软件更分散,更依赖品类和个体差异。 一个在A游戏里是“兴奋型”的功能,在B游戏里可能只是“基本型”。这也解释了为什么咕咕的8个项目里,有些小创新在某个项目里是“神来之笔”,在另一个项目里却变成了“多余的东西”——不是小创新本身的问题,是它在那个项目里的Kano分类不同。
咕咕把Kano模型用在自己的项目里,不是为了做问卷调研(咕咕没有那个资源),而是为了做一个思维分类:当咕咕面对一个小创新的时候,咕咕先问自己——这个东西对目标玩家来说,是“没有会不满”的基本型,是“越有越好”的期望型,还是“有了会惊喜”的兴奋型?如果是基本型,它必须进“必须做”的集合。如果是期望型,它进ICE或相对权重的排序池。如果是兴奋型,它需要被格外谨慎地对待——因为兴奋型功能的投入产出比最不确定,而且最容易变成“小创新打断进程”的案例。
第四个工具是Feature Freeze,需求冻结。 这是咕咕从一位游戏PM的分享中学到的。那位PM在播客里讲了一个咕咕觉得特别真实的经历:他先试过“锁提交”——锁住代码提交,结果既没稳住版本,又打断了团队节奏、让工作状态不可见。反思之后,他转向“锁需求”——真正想控制的不是代码量,而是变化量 。
咕咕读到这段话的时候,有一种被击中的感觉。咕咕的8个停摆项目里,有至少三个是因为“变化量失控”而死的。咕咕从来没有试过“锁提交”,但咕咕试过类似的东西——咕咕告诉自己“这个项目从这个版本开始不再加新功能”。结果呢?咕咕在第三天就加了一个“就这一次”的小巧思,然后在第五天又加了一个“这个真的很重要”的小巧思。咕咕没有意识到的是,口头宣布“冻结”和真正落地隔着距离 。那个PM的做法是:还没开始的、新提的一律砍,非进不可的走单独确认流程,并在关键节点主动把制作人拉出来背书。咕咕没有制作人,但咕咕可以给自己建立一个“单独确认流程”——任何在冻结期内的新需求,必须写进一个专门的文档,并且必须在文档里回答一个问题:“如果不做这个,当前版本的核心体验会受到什么损失?” 如果咕咕写不出一个有说服力的回答,这个需求就不进。
那个PM还提了一个咕咕觉得可以立刻用的做法:Bug日清加熔断时间。高/紧急Bug当天清,晚上十点设熔断升级。本质不是加班管理,而是把“什么时候该紧张”量化出来——靠体感判断的问题在于,每个人紧张阈值不同,而且没有标准的时候,催人全靠嘴皮子。咕咕是单人开发,没有“催人”的问题,但咕咕有“自己催自己”的问题。咕咕经常在晚上十一点还在调一个数值,因为“总觉得再调一下就好了”。熔断时间的逻辑是:到了某个时间点,不管状态如何,停止。 咕咕试了一周,发现真正有用的不是“停止”本身,而是在停止之前,咕咕会更有意识地选择做什么。因为咕咕知道十点之后不能做了,所以咕咕在九点半的时候会更认真地判断“现在做的这件事值不值得”。
并发并行与串行:一个咕咕还在摸索的边界
那个PM的分享里还提到了“影响评估→打标分类→量化影响→全流程管理”的临时需求消化四步法,以及“每加一个都说清挤掉了什么”的优先级置换原则。咕咕觉得后者特别重要。咕咕之前加一个小创新的时候,从来不说“这个挤掉了什么”,咕咕只是说“这个也做”。“也”字是开发权重最大的敌人。 因为“也”意味着没有交换,只有增加。咕咕后来强迫自己在每次加东西的时候,写一句话:“这个挤掉了____。”如果咕咕填不出这个空,说明咕咕还没有准备好加它。
但咕咕在这一章里最想强调的,不是这些工具本身,而是一个更底层的区分:什么可以并行,什么必须串行。
咕咕的8个停摆项目里,有一个项目死于“什么都想并行”。咕咕同时推进战斗系统、叙事系统、美术资源、数值平衡。咕咕的想法是“多线并行效率高”。结果是:战斗系统的改动影响了数值平衡,数值平衡的改动影响了叙事节奏中“角色成长”的呈现方式,叙事节奏的改动又反过来让战斗系统中某个技能的设定变得不合理。四条线互相污染,咕咕每天都在救火,但火是从四个方向同时烧过来的。
后来咕咕学会了一件事:独立模块可以并行,非独立模块必须串行。 什么是独立模块?美术资源和核心系统开发是独立的——美术资源的产出不依赖战斗系统的数值,战斗系统的数值也不依赖美术资源的进度。它们可以并行。但战斗系统和数值平衡不是独立的——数值平衡的调整依赖于战斗系统的机制确定。它们必须串行。叙事系统和角色成长系统也不是独立的——角色成长的情感节奏依赖于叙事弧线的推进节点。它们必须串行。
咕咕把这个原则和上下文治理连接起来:并行的前提是上下文隔离。 如果两条线共享同一个决策空间,它们就不能并行,因为一条线的决策会污染另一条线的上下文。只有上下文被隔离——美术有自己的约束文档,战斗系统有自己的约束文档——它们才可以并行推进而不互相干扰。
这个原则听起来简单,但咕咕在实践中的难点是:判断“独立”还是“非独立”本身就需要判断。 咕咕的一个项目里,咕咕以为“角色技能设计”和“关卡设计”是独立的,因为技能是战斗系统的事,关卡是叙事系统的事。但咕咕后来发现,关卡中的战斗节奏设计直接依赖于技能的可用性和冷却时间。它们不独立。咕咕花了两周时间做了十几个关卡,然后发现所有关卡的战斗节奏都需要根据技能系统的改动重新调整。
咕咕现在的做法是:在并行之前,先做一次依赖扫描。把每个模块列出来,然后问:如果A模块的约束发生变化,B模块是否需要跟着变?如果答案是“需要”,它们就不独立。这个扫描不需要精确到每个细节,只需要识别出那些“强依赖”的模块对。强依赖的模块对必须串行。
第五章 自动化与参数化:测试效率的量化证据
咕咕的8个停摆项目里,测试一直是“最不重要的事”。咕咕的逻辑是:先把东西做出来,测试以后再说。这个逻辑听起来合理,但它有一个致命的漏洞:“以后”永远不会来。 当咕咕终于觉得“可以测试了”的时候,项目已经积累了太多需要测试的东西,而咕咕的手工测试能力远远不够。咕咕试过最笨的办法:打开游戏,手动走一遍流程,记录问题,修改,再走一遍。一个中型项目的全流程走一遍需要大概两分钟——咕咕说的是“全流程”,从进入游戏到退出,经过所有系统。如果咕咕要覆盖所有的边缘情况、所有的数值组合、所有的分支路径,咕咕估计需要两天。而咕咕只有一个人。两天不写代码、不做设计、不推进任何东西,只做测试。咕咕试过一次,在第二天下午放弃了。
这不是咕咕一个人的问题。咕咕后来看到一组数据:中等复杂度的游戏项目平均维护超过500个测试脚本,每次版本更新导致30%的脚本失效,维护成本占测试总投入的45%。咕咕看到这个数据的时候,第一反应是“500个脚本?咕咕连5个都没有。”第二反应是“30%的失效率?那咕咕就算写了500个,每次更新之后也要修150个。”第三反应是“45%的维护成本?咕咕的测试总投入本来就不够,45%的维护成本意味着咕咕能用来做新测试的资源更少。”
这组数据让咕咕意识到一件事:测试不是“做完了再测”,测试是贯穿整个开发过程的。 而咕咕的8个停摆项目,全部死于“把测试推到以后”。
Zynga的数据:自动化测试的ROI不是理论
咕咕之前对自动化测试有一个偏见:觉得那是大团队才配拥有的东西,单人开发者用不起。咕咕的这个偏见被一个案例打破了。
Zynga——对,就是那个做《FarmVille》的公司——在某个阶段面临一个选择:他们的每日生产发布流程需要手动测试,随着玩家流量和功能速度的增长,测试成本急剧上升。他们当时面临的挑战包括:每日生产发布造成不可持续的QA工作量,手动回归测试需要持续加班,大约每周30小时以上;每个测试人员每天还要额外加班一小时才能跟上发布节奏;外包QA承包商每周增加40小时的测试能力,但增加了经常性成本;按照当时的速度,两年内需要招聘超过100名手动测试人员。
咕咕读到“100名手动测试人员”这个数字的时候,停下来想了很久。咕咕只有一个人,咕咕的8个项目加起来可能都不需要100个人。但咕咕从Zynga的数据里看到的不是“大公司的问题”,而是一个比例:当手动测试的成本增长速度超过开发速度的时候,自动化测试不是“可以做的事”,是“必须做的事”。
Zynga最终的解决方案是:用3名自动化工程师替换了手动测试团队,消除了加班和外包,同时交付了更快的发布和更好的质量。结果数据是:头一年第二季度到第四季度逐步增加执行许可,第二年逐步淘汰手动测试人员和外包承包商。自动化回归套件替换了重复的手动验证,实现了超过30万美元的年度节省,投资回收期在两年以内 。
咕咕把这个案例和咕咕自己的情况对照。咕咕没有30万美元可以省,咕咕也没有100个测试人员可以裁。但咕咕有一个东西和Zynga一样:时间。 咕咕花在手动测试上的时间,就是咕咕花在开发上的时间的对手。咕咕每花一个小时手动测试,就少了一个小时开发。咕咕的8个停摆项目里,至少有两个的直接死因是“咕咕把太多时间花在了手动测试上,以至于没有时间推进新内容”。不是测试本身杀死了项目,是测试没有自动化杀死了项目。
另一个案例让这个对比更具体。游戏元数据服务公司Gameopedia的QA团队之前使用基于Python的Selenium脚本做UI测试,面临的问题包括:动态页面组件频繁破坏定位器,需要手动调试和脚本更新;设计测试框架和编写脚本需要一周的前期规划,新QA工程师需要大约30天才能达到生产力。他们后来转向了AI辅助的测试自动化,结果:维护时间减少超过40%,每位QA工程师每天节省2到3小时之前花在脚本修复上的时间;新工程师达到完全生产力的时间从大约30天缩短到2到5天 。
咕咕从Gameopedia的案例里提取的关键数据不是“40%”,而是“2到3小时” 。咕咕算了一笔账:如果咕咕每天能节省2小时,一周就是10小时,一个月就是40小时。40小时对于一个单人开发者来说,差不多是一个完整的工作周。咕咕的一个停摆项目,如果当初有这每周10小时,可能就不会卡在那个特定的版本上。
参数化:把“测试什么”和“怎么测”分开
咕咕在自动化测试这条路上遇到的最大障碍不是“要不要自动化”,而是“怎么自动化”。咕咕试过写测试脚本,但很快就发现了一个问题:每一个测试都在重复写类似的东西。 测试“技能A的伤害计算”和测试“技能B的伤害计算”,除了数值不同,逻辑几乎一模一样。咕咕写了十个测试之后,发现自己复制粘贴了十次几乎相同的代码,只改了里面的几个数字。
这就是“参数化”要解决的问题。参数化测试的核心思想是把测试数据和测试逻辑分开:测试逻辑写一次,数据以参数的形式传入,用同一段逻辑跑不同的输入组合。咕咕在一个开源项目的实践记录里看到了一个具体的对比:测试文件包含显著代码重复(估计40%以上),同样的测试为每种语言复制粘贴;通过转换为参数化测试,测试文件总行数减少了约40%,而所有测试仍然通过 。另一个案例中,通过参数化将测试文件从169行减少到41行,减少了128行代码,测试覆盖保持不变(1096个测试,92.01%覆盖率)。
咕咕把这些数据翻译成自己的语言:如果咕咕有一个测试需要覆盖5个技能、每个技能有3种数值组合、每种组合有2种触发条件,咕咕需要写30个测试用例。参数化之后,咕咕写1个测试逻辑,传入30组参数。 代码量从30份变成1份,修改逻辑的时候只需要改1个地方,而不是30个地方。咕咕之前在手动测试中最大的痛苦就是“改了一个数值要重新走30遍流程”。参数化之后,咕咕改一个参数,跑一次自动化,30组结果全部出来。
咕咕后来理解到,参数化不仅是一个测试技术,它是上下文治理在测试层面的体现。第三章里咕咕说过,策划的上下文和程序的上下文需要隔离。参数化就是隔离在测试里的对应物:测试数据(策划视角:这个技能的伤害应该是多少)和测试逻辑(程序视角:伤害计算是否正确)分开。 策划改数值的时候不需要碰测试逻辑,程序改逻辑的时候不需要碰数值。两者通过参数接口连接。
咕咕在停摆项目里最大的教训之一是:当数值和逻辑混在一起的时候,改数值就等于改逻辑,改逻辑就等于改数值。 咕咕有一次调一个技能的伤害值,调完之后发现测试脚本里的断言也“顺便”被改了——咕咕在修改数值的时候不小心删掉了一行断言。那个删除没有被发现,因为咕咕没有跑完整的测试。两周后咕咕发现了一个bug,追踪到那个技能,然后发现断言早就没了。测试没有参数化,就没有真正的“测试” ——你只是在手动确认一些你已经在脑子里确认过的东西。
能用数值代替的就参数化:一条咕咕还在学习的规则
咕咕在这一章想提出一条规则,它比“写自动化测试”更根本:游戏中所有能用数值代替的东西,尽量都用数值代替。
咕咕说“尽量”,是因为咕咕知道有些东西无法完全数值化。叙事的情感节奏、画面的表达规则、游戏性的手感——这些是第七章要处理的问题。但咕咕在开发过程中发现,很多咕咕以为“无法数值化”的东西,其实是可以的。 咕咕举几个具体的例子:
技能的冷却时间、伤害值、持续时间 ——这些当然可以数值化,咕咕已经在做了。
战斗中的镜头震动幅度和频率 ——咕咕以前觉得这是“手感”,没法数值化。但咕咕后来发现,咕咕可以用“震动幅度:小/中/大”和“触发条件:暴击/格挡/普通命中”来参数化。虽然不是精确的数值,但分类型的参数化已经足够让咕咕在测试中覆盖主要组合。
叙事事件中的情感强度 ——这个咕咕还在摸索。咕咕试过用“平静/紧张/悲伤/愤怒”四档来标记关键叙事节点,然后在测试中检查这些节点之间的过渡是否符合预期的情感曲线。它不完美,但它让咕咕第一次有了一个可以被自动化检查的叙事约束。
咕咕在这些尝试中得到的最大启发是:参数化的本质不是“把东西变成数字”,而是“把东西变成可以被自动化验证的约束”。 一个技能冷却时间是一个数值参数。一个情感节点被标记为“悲伤”,然后在自动化测试中检查这个节点前后的情感标签是否形成了一个合理的过渡——这也是参数化。咕咕之前觉得“只有数字才能参数化”,是因为咕咕把参数化理解得太窄了。参数化的核心是把“什么是对的”从人的直觉里拿出来,放进一个可以被重复验证的结构里。
从测试回到上下文:自动化是上下文治理的执行层
咕咕现在想把这一章和第三章连接起来。
第三章里,咕咕提出了“约束文档”——项目级约束、模块级约束、上下文隔离规则。约束文档回答的是“什么不能变” 的问题。但约束文档本身不能执行。它写在纸上,写在文档里,写在咕咕的脑子里。如果没有一个执行层,约束文档就会变成一个“理想中的规则”,而咕咕的开发流程仍然是“凭感觉走”。
自动化测试和参数化就是约束文档的执行层。 约束文档说“所有伤害必须走统一管线”,自动化测试检查是否有伤害计算绕过了管线。约束文档说“主角的成长必须经历三次失去”,自动化测试可以检查叙事事件是否按预期顺序触发。约束文档说“这个模块的数值参数在一个特定范围内”,参数化测试可以在每次构建时验证这个范围没有被违反。
咕咕在8个停摆项目里从来没有建立过这个执行层。咕咕的约束存在于咕咕的脑子里,但咕咕的脑子会疲劳、会遗忘、会被新的小创新吸引。自动化测试是咕咕的脑子的延伸,它不会疲劳、不会遗忘、不会被小创新吸引。 咕咕不需要它来判断“什么是对的”,咕咕需要它来判断“有没有偏离什么是对的”。
Zynga的数据显示自动化回归套件替换了重复的手动验证,实现了超过30万美元的年度节省。Gameopedia的数据显示维护时间减少超过40%,每位QA工程师每天节省2到3小时。这些数据的意义不在于“自动化比手动更便宜”——虽然这当然是真的。它们的意义在于:自动化测试把人的判断力从重复劳动中解放出来,放到了更重要的地方。 咕咕之前把所有时间花在了手动走流程上,以至于咕咕没有时间去思考“这个流程本身是不是对的”。自动化测试之后,咕咕走流程的时间减少了,思考“流程对不对”的时间增加了。
咕咕这一章的结尾是:做游戏最奢侈的资源不是时间,是判断力。 手动测试消耗判断力——咕咕需要判断每次走流程的结果是否正常。自动化测试不消耗判断力——它只是报告“通过”或“失败”。咕咕的8个停摆项目中,判断力全部被手动测试、上下文污染、小创新打断消耗完了。留给“这个项目到底应该做成什么样”的判断力,几乎为零。
第六章 发布模板:测试版漏斗的行业参照
咕咕体感上有一个成功模板,但它和咕咕之前写过的所有章节不一样——咕咕没有试过它。
咕咕只能诚实地把体感说出来:不断做测试版本,一直更新测试版本。当测试版的人数达到了5000到1万左右,到了一种玩家不得不让你公开发表的时候,再点击正式上线。 这就是咕咕心目中的“破圈模板”——一个项目从测试版走向正式版的标准路径。咕咕没有走通过这条路,但咕咕觉得它值得被认真对待,因为咕咕在行业数据里看到了大量和这个体感吻合的证据。
先从一个最直接的案例开始。
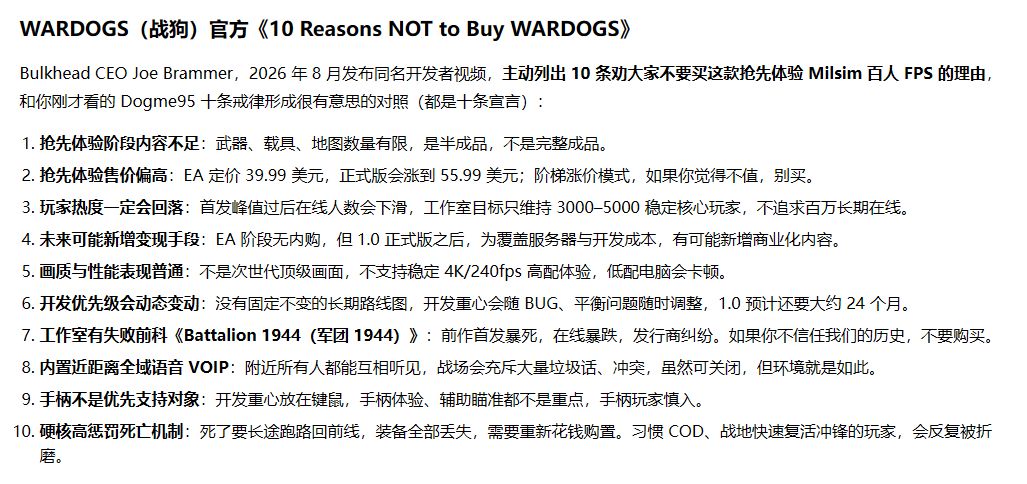
WARDOGS是一款100人战术FPS游戏,由BULKHEAD开发、Team17发行。它在Steam上的愿望单在公布三天后就达到了10万,5月突破50万,8月突破100万。与此同时,将近50万玩家加入了8月的封闭测试,最终测试的Steam并发玩家峰值达到了245,118人。正式进入Early Access的第一天,销量突破100万份,Steam同时在线玩家峰值超过34万。BULKHEAD的CEO Joe Brammer在新闻稿里的原话是:“我们花了几个月告诉人们WARDOGS是什么、不是什么,甚至一度列了十个理由劝大家别买。我们不想让人们盲目跟风购买。”
咕咕从这个案例里提取的不是“100万销量”这个数字,而是它背后的节奏:公布→愿望单积累→封闭测试→最终测试→Early Access。每一个环节都在为下一个环节蓄力。最终测试的245,118名并发玩家,几乎是把“这个游戏值得买”这件事提前演示了一遍。等到正式进入Early Access的时候,玩家已经不是在“决定要不要买”,而是在“确认自己早就想买的东西终于可以买了”。(咕咕非常喜欢这个游戏,一起B测,和30w玩家一起凌晨蹲点发布)
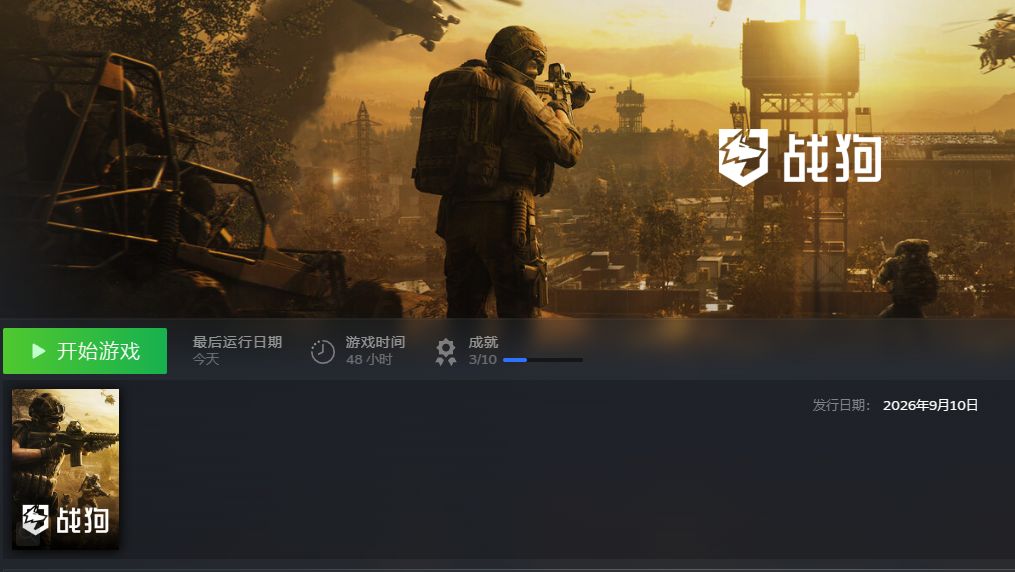
9.14日截图
另一个案例是Manor Lords。这款中世纪城市建造游戏在Steam上积累了超过320万愿望单(平纪录),Steam Next Fest期间约50万玩家添加了愿望单,在Early Access上线前两周又增加了80万愿望单。Early Access上线后不到24小时销量突破100万,不到三周突破200万。更关键的一个数字是:截至Game Developer采访时,Manor Lords的终身愿望单转化率是26%。
咕咕看到26%这个数字的时候停了一下。GameDiscoverCo在2025年发布的报告显示,Steam平台上平均愿望单转化率是0.15,也就是每100个愿望单中有15人最终购买。Manor Lords的26%远高于这个平均水平。但咕咕更在意的是另一个事实:Manor Lords在Steam Next Fest期间的Demo表现,是Hooded Horse判断这个项目“可能会好”的核心依据之一。发行商CEO Tim Bender说,Next Fest Demo在活动期间产生了大约50万愿望单,这才让他们开始认真评估项目的潜力。
咕咕把这两个案例放在一起,看到了一个清晰的模式:测试版不是“正式版的阉割版本”,它是正式版的预演。 玩家在测试版中体验到的内容质量、系统完整度、性能表现,决定了他们是否会转化为正式版的购买者。而这个转化的路径,不是“测试版→正式版”的跳跃,而是“测试版→愿望单→正式版”的漏斗。
咕咕想在这里插入一个必须被正视的数字。Newzoo基于2021至2024年间37个国家(不含中国和印度)的数据,分析了抢先体验时长与正式发布后表现之间的关系。结论是:抢先体验持续4到9个月的游戏,在正式发布后三个月内的新玩家增长表现最好,约6个月时达到最优峰值。 过长或过短的测试周期都会对正式发布产生不利影响。咕咕的体感模板里没有提到“时长”,但Newzoo的数据补上了这个维度。5000到1万测试玩家这个规模,如果在一个4到6个月的周期内达成,那它对应的就是一个比较健康的发布节奏。如果拖了两年才达到这个规模,热情可能已经被消耗掉了。
但咕咕在这一章里最想讨论的不是“测试版该做多大”,而是一个更底层的问题:为什么测试版能让玩家“不得不让你公开发表”?
咕咕的答案是:测试版让玩家参与了项目的上下文。
在前面的章节里,咕咕反复强调“上下文治理”——策划和程序需要不同的上下文,AI协作需要隔离的上下文。但玩家和开发者之间,也需要一种特殊的上下文关系。在传统发布模式里,玩家只在正式上线后才接触游戏,他们的上下文里只有“最终成品”。开发者决定一切,玩家只能接受或拒绝。但在测试版模式里,玩家提前进入了项目的上下文——他们看到了系统的不完整、体验到了数值的粗糙、感受到了某些机制的雏形。他们对这个项目的“上下文”产生了情感投入。
WARDOGS的案例里有一个细节:BULKHEAD在测试期间收集了数千条社区剪辑、直播和视频。这些内容给了玩家一个“未经过滤的视角”去看游戏的样子。咕咕读到这里的时候想到的是:这些剪辑和视频,本质上就是玩家的上下文在向其他玩家传播。一个玩家在测试版里体验到的某个瞬间——某个混乱的团战、某个离谱的击杀、某个哭笑不得的失败——被记录下来、传播出去,变成了另一个玩家决定“我也要加入”的理由。这个传播链条,是任何营销手段都买不到的。
咕咕在这里需要辩证地看一件事。测试版漏斗不是万能的,它有一个前提条件:测试版本身必须是一个“好玩的半成品”。 WARDOGS的CEO说他们“列了十个理由劝大家别买”,这听起来很酷,但它背后的前提是这个游戏在测试阶段已经有了足够让玩家留下的核心体验。如果测试版本身不好玩,“玩家不得不让你公开发表”这件事永远不会发生。玩家不会因为“测试版更新了很多次”而感动,他们只会因为“测试版好玩”而留下。
咕咕的8个停摆项目里,如果有任何一个做过测试版漏斗,会怎样?咕咕想了想,大部分项目可能在第一个测试版就会被玩家拒绝。不是因为玩家苛刻,而是因为咕咕的项目在“好玩”这个维度上确实没有通过。测试版漏斗的残酷之处也在这里:它不给你“以后会好的”这个借口。 玩家玩到的是什么,他们判断的就是什么。如果测试版不够好,漏斗的入口就断了,后面所有的环节都不会发生。
第七章 叙事游戏:无法参数化的上下文
咕咕在这一章开头需要说一句可能不太“正确”的话:叙事游戏是咕咕做过的最难的项目类型,比任何一个系统向项目都难。
这个判断不来自理论,来自咕咕做第一个叙事游戏时的经历。咕咕当时经历了一些人生的波动,那种波动让咕咕有一种强烈的、必须表达什么的冲动。叙事游戏是咕咕找到的表达出口。但咕咕很快发现了一件事:表达和制作是两件完全不同的事,而叙事游戏强迫你同时做这两件事。
咕咕在这一章里想先引入一组行业案例,它们让咕咕确认了一件事:咕咕在第一个叙事游戏里感受到的痛苦,不是咕咕一个人的问题。
《极乐迪斯科》是2019年最受好评的叙事RPG之一。但它的开发过程,用主创Robert Kurvitz的话来说,是“思维粉碎者”——“太绞杀脑细胞和损耗生命值了。”ZA/UM团队只有25人,其中8位是编剧。Kurvitz自己评估故事创作的工作量与《质量效应:仙女座》相当。他说的原话是:“这是目前地球上最难的写作任务。”
但这还不是最让咕咕触动的地方。2025年发布的一部关于《极乐迪斯科》开发历程的纪录片揭示了一个更复杂的图景。编剧Argo Tuulik在纪录片中说:“最后九个月……这是超级大干。九个月里,我想我每周至少有一个晚上没睡。之后,每个人都崩溃了,筋疲力尽。”Robert Kurvitz说开发过程“完全无情”,指责“完全不切实际的截止日期”造成了这种压力。纪录片还揭示了团队内部的创意混乱:一个人起草场景,另一个人修改,第三个人校对并添加新内容,第四个人秘密做更多改动。编剧和编辑之间没有明确分工——每个人都做所有工作。废弃教堂的剧情被重写多次,成为工作室内部混乱的缩影。
咕咕把这段话和前面章节里反复讨论的“上下文治理”放在一起看,发现了一个问题:《极乐迪斯科》的创作团队没有上下文治理。 每个人都在同一个上下文里工作——同一个剧本、同一个世界观、同一个叙事空间——但没有人负责隔离不同的写作视角。结果是,四个人同时改同一个场景,没有一个人知道另外三个人在改什么。这不是“没有上下文治理”的极端案例,这是上下文污染的极端案例。
但咕咕需要在这里做一个非常重要的辩证区分。《极乐迪斯科》的上下文污染,恰恰是它成为一部伟大作品的原因之一。 如果ZA/UM团队在一开始就建立了严格的上下文隔离——一个人负责世界观、一个人负责角色对话、一个人负责情节推进,彼此不交叉——那《极乐迪斯科》可能会更“干净”,更“可控”,但它可能不会拥有那种让玩家沉迷的混乱的丰富性。那种丰富性来自创作者之间的碰撞、改写、否定、再碰撞。它不符合任何工程管理的原则,但它产出了一部工程管理无法产生的作品。
咕咕在这个案例里看到了一个悖论:叙事游戏需要上下文治理来保护创作者不被消耗,但上下文治理的过度应用会杀死叙事游戏的灵魂。
另一个案例让咕咕看到了这个悖论的另一面。《苏丹的游戏》是一款国产叙事游戏,文本量超过140万字,核心开发团队最初仅有11人。制作人“远古之风”在开发者交流活动中说了一句让咕咕反复回味的话:“不要先想‘我想做什么样的游戏’,而是先盘点自己手头已经有的资源,看看‘我能做什么样的游戏’。”
这句话和咕咕在前面章节里讨论的“开发权重”是同一个逻辑:先确定约束,再在约束里创作。 《苏丹的游戏》之所以能在11个人的团队里做出140万字的叙事体量,恰恰因为它从一开始就接受了“游戏里没有任何东西会动”这个约束——双头龙工作室当时“公司快破产了,所有会动的东西、能动的人都离职了”。这个约束不是设计选择,是现实逼迫。但它变成了一个创作上下文:当你的团队没有能力做动画、做实时战斗、做大规模3D场景的时候,你把所有的创作资源集中到文本和叙事结构上。这就是叙事游戏的上下文治理——不是管理“做什么”,而是管理“不做什么”。
但咕咕在这一章里最想讨论的,不是这些案例本身,而是一个咕咕在第一个叙事游戏里花了最长时间才理解的事实:叙事游戏的取舍标准,和其他项目不一样。
咕咕在其他项目里做取舍的时候,用的标准是“哪个方案对玩家体验更好”“哪个系统更高效”“哪个设计更符合项目目标”。这些标准可以被量化,可以被测试,可以被自动化验证。但在叙事游戏里,这些标准经常失效。
咕咕举一个具体的例子。咕咕在做一个叙事节点的时候,有两个方案。方案A是:主角在这个节点做出了一个“正确”的选择,符合角色的成长弧线,情感逻辑清晰。方案B是:主角在这个节点做出了一个“错误”的选择,违背了角色的成长弧线,但更真实——因为真实的人在创伤中往往做出不理性的选择。从游戏性的角度看,方案A更好:玩家更容易理解角色的动机,更容易与角色产生共鸣,更不容易产生“这角色怎么这么蠢”的挫败感。从叙事的角度看,方案B更好:它更接近咕咕想表达的那种“人在痛苦中的不完美”。
咕咕在第一个叙事游戏里纠结了很久,最后选了方案A。不是因为咕咕觉得方案A更好,而是因为咕咕无法公正地比较它们。方案A有可量化的优势,方案B没有。方案B的优势是“更真实”,但“更真实”是无法被参数化的。你没法写一个自动化测试来验证“这个叙事选择是否更真实”。
咕咕后来意识到,这个困境的本质是:叙事游戏的上下文里包含大量无法被参数化的变量。 情感节奏、角色的内在一致性、表达的诚实度——这些变量可以被感受,可以被讨论,但无法被数值化。咕咕在第三章里说“能用数值代替的就参数化”,但叙事游戏里有很多东西不能用数值代替。这不是咕咕的失败,这是叙事游戏的本质。
叙事游戏的取舍,只能由人来完成。而且必须由同一个人来完成。咕咕在第一个叙事游戏里试过“把叙事决策外包”——咕咕和一个朋友讨论剧情,朋友给了很多建议,有些建议在逻辑上比咕咕原来的方案更好。但咕咕最终没有采纳。不是朋友说得不对,而是那些建议虽然“更好”,但它们不是咕咕想说的东西。叙事游戏的核心不是“最好的叙事”,而是“作者想说的叙事”。这个“想说”的东西,在咕咕的上下文里,不在朋友的上下文里。
咕咕在这一章的末尾需要做一个严肃的声明。前面几章讨论的所有工具——约束文档、开发权重、ICE方法、自动化测试、参数化、测试版漏斗——它们对叙事游戏依然有效,但它们的效力边界不一样。 约束文档对叙事游戏依然重要,它保护叙事上下文不被工程决策污染。开发权重对叙事游戏依然重要,它帮助咕咕决定先写哪条线、后写哪条线。自动化测试对叙事游戏依然重要,它可以检查叙事事件是否按预期顺序触发、角色状态是否一致、分支路径是否可达。但这些工具能处理的都是工程层面的问题。它们不能处理叙事游戏最核心的问题:作者想说什么,以及作者愿不愿意承担这个表达的代价。
咕咕做第一个叙事游戏的时候,最大的发现不是“叙事游戏很难做”,而是“叙事游戏会逼你面对自己”。你在系统向项目里可以躲在机制后面——你说“这个系统是为了让玩家有更好的体验”,这句话是真的,但它不是关于你自己的。你在叙事游戏里躲不了。你写的每一段对话、每一个选择、每一个角色的命运,都在回答一个问题:你到底想说什么? 如果答案是“不知道”,叙事游戏会把这个“不知道”放大一万倍,直到你无法忽视。
咕咕的第一个叙事游戏,用了比预期长得多的时间。不是因为技术问题,不是因为工具问题,是因为咕咕一直在和自己打架。咕咕想让故事“好看”,但咕咕的内心想让故事“真实”。咕咕想做一个玩家会喜欢的游戏,但咕咕的内心想让这个游戏说出那些咕咕自己都不敢说的话。这个打架的过程,就是叙事游戏最消耗心力的部分。它不可能被自动化测试覆盖,不可能被开发权重排序,不可能被约束文档约束。它只能被经历。
尾声:取舍是创作最快乐也最痛苦
咕咕写这篇文章的时候,翻了很多之前停摆项目的记录。
有一些记录写得很详细,有完整的策划文档、有程序迭代的版本号、有咕咕在深夜写的“今天又卡住了”的备注。有一些记录只有几行字,写着“这个项目放弃了”或者“暂时不想做了”。8个项目,有的停了大半年,有的停了不到一周,有的咕咕已经不确定自己还想不想捡起来。
但咕咕在这篇文章里学到的最重要的一件事,不是“怎么让项目不停摆”。是停摆本身有结构。
SuperScale的数据说,43%的手游项目在开发中被取消,83%的手游在三年内死亡。Petrillo等人的研究说,游戏开发中最常见的问题不是技术问题,是范围、功能蔓延和功能削减。Bent Flyvbjerg说,只有0.5%的大项目按时、按预算、且实现了预期收益。这些数字摆在一起,咕咕的8个项目停摆就不像是一件“咕咕运气不好”的事了。它像是一个行业级规律在个体身上的局部表现。
但这篇文章真正想说的话,不是“所以停摆是正常的,别太难过”。那句话太轻了,轻得像是在给失败找借口。咕咕想说的是:停摆有结构,就意味着停摆可以被诊断,可以被干预,可以被分类。
这就是为什么咕咕要在最后对8个项目做一次归类诊断。不是为了给它们“判刑”,是为了让咕咕自己——也让可能读到这篇文章的同行——看到一件事:停摆不是一个模糊的、令人沮丧的“不行了”,它是一个有具体病灶的状态。有的病灶可以治,有的需要截肢,有的需要承认“这个项目从一开始就不应该开始”。
在进入诊断之前,咕咕想用几句话把整篇文章的概念收束一下。因为它们不是独立存在的,它们在咕咕的脑子里形成了一个互相咬合的结构。
约束文档是地基。它回答“什么不能变”。没有它,后面所有的工具都会失效,因为没有参照系。
上下文治理是框架。它回答“什么信息在什么位置做决策”。策划的上下文里只有叙事和情感节奏,程序的上下文里只有系统和数值,两个上下文共享约束文档,但不共享决策空间。Drew Breunig总结的四种上下文失效模式——中毒、分心、混淆、冲突——在咕咕的8个项目里全部出现过,只是咕咕当时不知道它们有名字。
开发权重是排序器。它回答“先做什么”。ICE方法适合快速比较,相对权重法适合把“不做会怎样”放进决策框架,Kano模型适合判断“这个功能对玩家意味着什么”,Feature Freeze适合在中期锁住变化量。
自动化与参数化是执行层。它回答“做出来的东西有没有偏离约束”。Zynga用3名自动化工程师替换了100名手动测试人员的规划,实现了超过30万美元的年度节省。Gameopedia的QA团队维护时间减少超过40%,每位工程师每天节省2到3小时。这些数字的意义不是“自动化更便宜”,而是判断力被从重复劳动中解放出来,放到了更需要判断力的地方。
测试版漏斗是验证层。它回答“这个东西玩家要不要”。WARDOGS在Early Access首日销量突破100万份,Manor Lords的愿望单转化率是26%——行业平均是15%。这些数字背后的逻辑是:测试版让玩家提前进入了项目的上下文,他们对“这个项目是什么”有了情感投入,而这种投入是任何营销手段都买不到的。
叙事游戏是不可通约的那一部分。它回答的是“我想说什么”。这个问题无法被参数化,无法被ICE排序,无法被上下文隔离完全保护。它只能被经历。咕咕做第一个叙事游戏时经历的痛苦,和《极乐迪斯科》团队经历的“思维粉碎”,在本质上是同一件事:表达是不可工程化的,但表达可以被工程化地保护。
这六个概念不是线性的。它们是循环的。约束文档需要被开发权重修正,开发权重需要被自动化测试验证,自动化测试需要被测试版漏斗校准,测试版漏斗的反馈会回到约束文档。而叙事游戏,它在这个循环之外,又在这个循环之内——它的工程部分可以被循环处理,它的表达部分不能被任何循环处理。
咕咕在这一章的末尾想说一句可能不太“分析”的话。做游戏最快乐的时候,是取舍创作的过程。不是做完的时候,不是上线的时候,不是看到玩家评论的时候——是坐在那里,面对两个看起来都对的选项,然后必须选一个的时候。那个瞬间,你知道了自己真正在乎什么。
结果也很重要。咕咕不否认这一点。一个没人玩的游戏和一个有很多人玩的游戏,在“结果”的意义上当然不一样。但咕咕在8个停摆项目里学到的最不后悔的一件事,是过程确实带来了很高的成长。每一次停摆都让咕咕对“什么不能变”多了一点理解,对“什么应该先做”多了一点判断,对“什么值得表达”多了一点诚实。
请继续相信游戏行业的美好。也请继续相信取舍的美好。
咕咕
9.14
(宇宙安全申明省略)
参考文献
[1] SuperScale. Good Games Don't Die (White Paper). Conducted by Atomik Research. Based on interviews with 500 game developers in the UK and US, 2023.
[2] Petrillo, F., Pimenta, M., Trindade, F., & Dietrich, C. (2009). What went wrong? A survey of problems in game development. Computers in Entertainment, 7(1), 1–22. DOI: 10.1145/1486508.1486521.
[3] Flyvbjerg, B., & Gardner, D. (2024). How Big Things Get Done: The Surprising Factors That Determine the Fate of Every Project, from Home Renovations to Space Exploration and Everything in Between. Signal.
[4] Breunig, D. (2025). How to Fix Your Context. dbreunig.com. Retrieved from How to Fix Your Context. Also see: LangChain. how_to_fix_your_context (GitHub repository).
[5] Wiegers, K. E. (1999). First Things First: Prioritizing Requirements. Software Development, September 1999.
[6] Gameopedia. From QA Grind to AI Gold: How Gameopedia Slashed Test Maintenance by 40%. Undercode Testing. Retrieved from https://undercodetesting.com.[reference:11]
[7] Lai, S., & Vecchi, D. (2024). Formal Constraints as Creative Fuel: A Comparative Study of Game Jams, Dogma ’95, Demo Scene, OuBaPo, and Japanese Renga. Games and Culture.
[8] Feijoo Melián, C., & Kultima, A. (2026). Deadline as Development Magic Circle: Reframing Temporal Constraints in Game Development. Aalto University.
[9] Anthropic. (2025). Multi-Agent Research System: Performance Evaluation of Context-Isolated Architectures. Anthropic Technical Report.
[10] Newzoo. (2025). Early Access Duration and Post-Launch Performance: A Cross-Regional Analysis of 37 Markets. Newzoo Insights.
[11] Zynga. (2019). Scaling QA: From Manual Testing to Automated Regression. Zynga Engineering Blog.
[12] Brammer, J. (2025). WARDOGS Early Access Launch Interview. BULKHEAD / Team17 Press Release.
[13] Bender, T. (2024). Manor Lords Wishlist Conversion and Steam Next Fest Performance. Hooded Horse / Game Developer Interview.
[14] Kurvitz, R., & Tuulik, A. (2025). Disco Elysium Development Documentary. ZA/UM Archive.
[15] 远古之风. (2024). 《苏丹的游戏》开发分享:先盘点资源,再想游戏. 双头龙工作室开发者交流活动.
[16] 杨梦舟. (2025). 腾讯游戏AI辅助开发的上下文工程实践. 腾讯游戏技术分享.
[17] 游戏自动化测试的颠覆式突破与实践指南. (2026). 51Testing.
[18] Databricks. (2024). Long Context Performance Evaluation: Llama 3.1 405B Context Degradation Analysis. Databricks Engineering Blog.
[19] Berkeley Function Calling Leaderboard. (2025). Tool Count and Model Performance: The Inverse Scaling of Tool Loadout. UC Berkeley.
[20] Microsoft & Salesforce. (2024). Prompt Splitting and Sequential Information Delivery: Performance Impact Analysis. Joint Research Report.
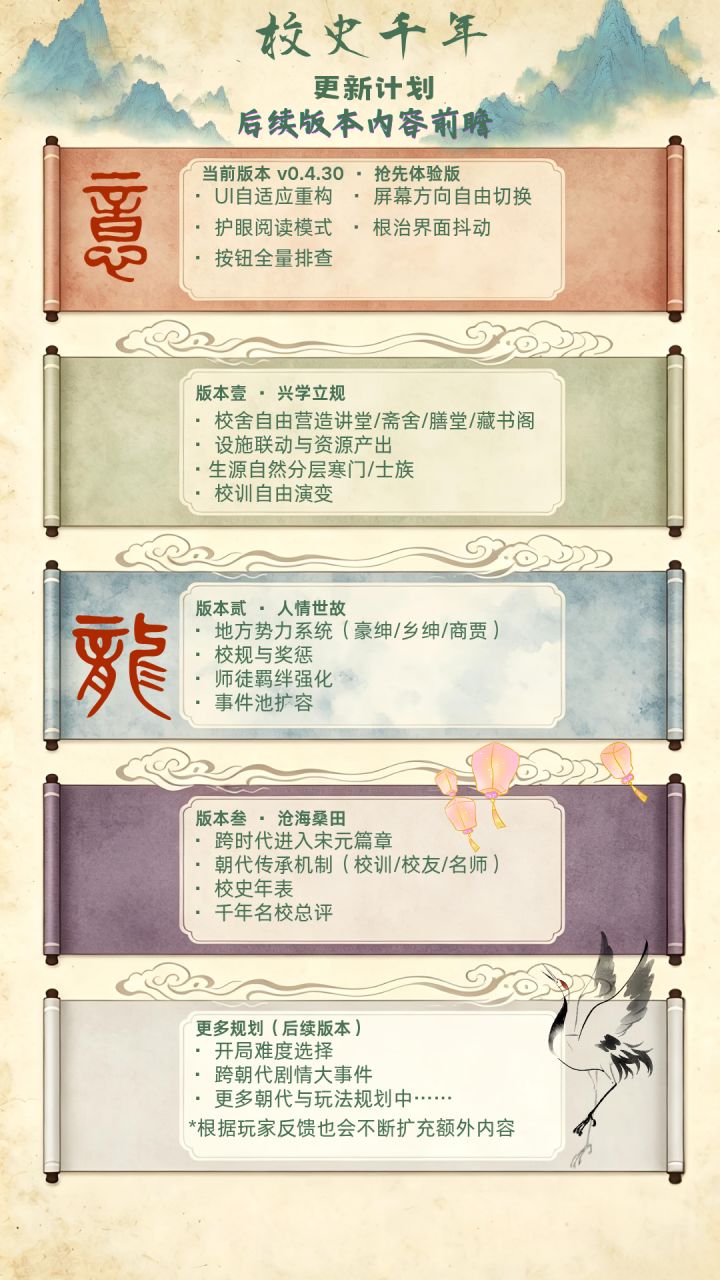
《校史千年》未来版本内容预告
这是《校史千年》的后续更新计划前瞻。
前阵子我们埋头做了一堆底层的 UI 适配和稳定性修复,现在终于可以把之后的路线图晒出来了。
版本壹 · 兴学立规
先把校舍营造做出来——讲堂、斋舍、膳堂、藏书阁自由建造,并引入生源自然分层(寒门/士族)和校训自由演变。
版本贰 · 人情世故
加入地方势力(豪绅、乡绅、商贾)的好感度,实装校规与奖惩,并强化师徒羁绊。
版本叁 · 沧海桑田
正式跨入宋元篇章,实现
@剑仙愁
1 赞
别再烧积分了!从每次 2000 到每次 50 的血泪经验
适用场景:所有在用 TapTap Code 开发游戏的小白
难度:★☆☆☆☆
背景最近群里总有人"炫耀"一次操作花了几千积分,说实话这不是值得高兴的事——这是在告诉所有人你的开发方式有根本性问题。我也走过这条弯路,所以来说说怎么改。
积分消耗的本质是什么积分 = AI 处理的 token 数量 = 你发给 AI 的内容 + AI 回给你的内容所以烧积分的本质只有两种:
你让 AI 做了大量无效/重
精华
@虎老大王
68 赞
21 回复
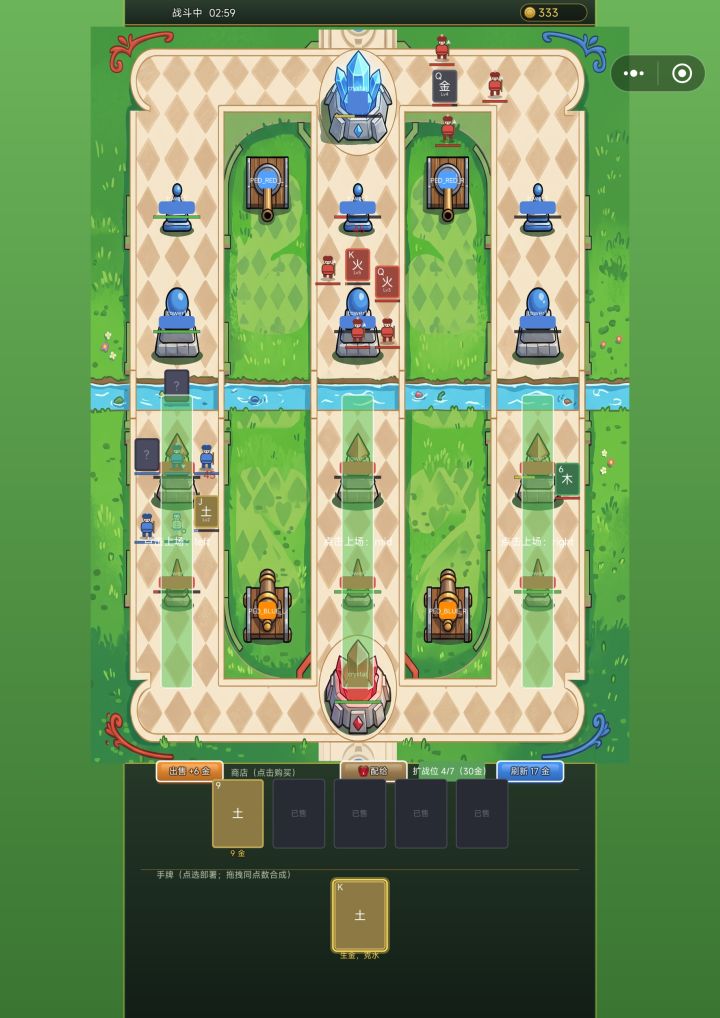
五行扑克战纪正式上线预告及今日更新
正式上线时间定为9月25日14点左右。
20260915更新:1.加入联机的聊天系统;
2.加入段位和排行榜功能
3.加入战绩和公告
@琪玉小鹏
03:06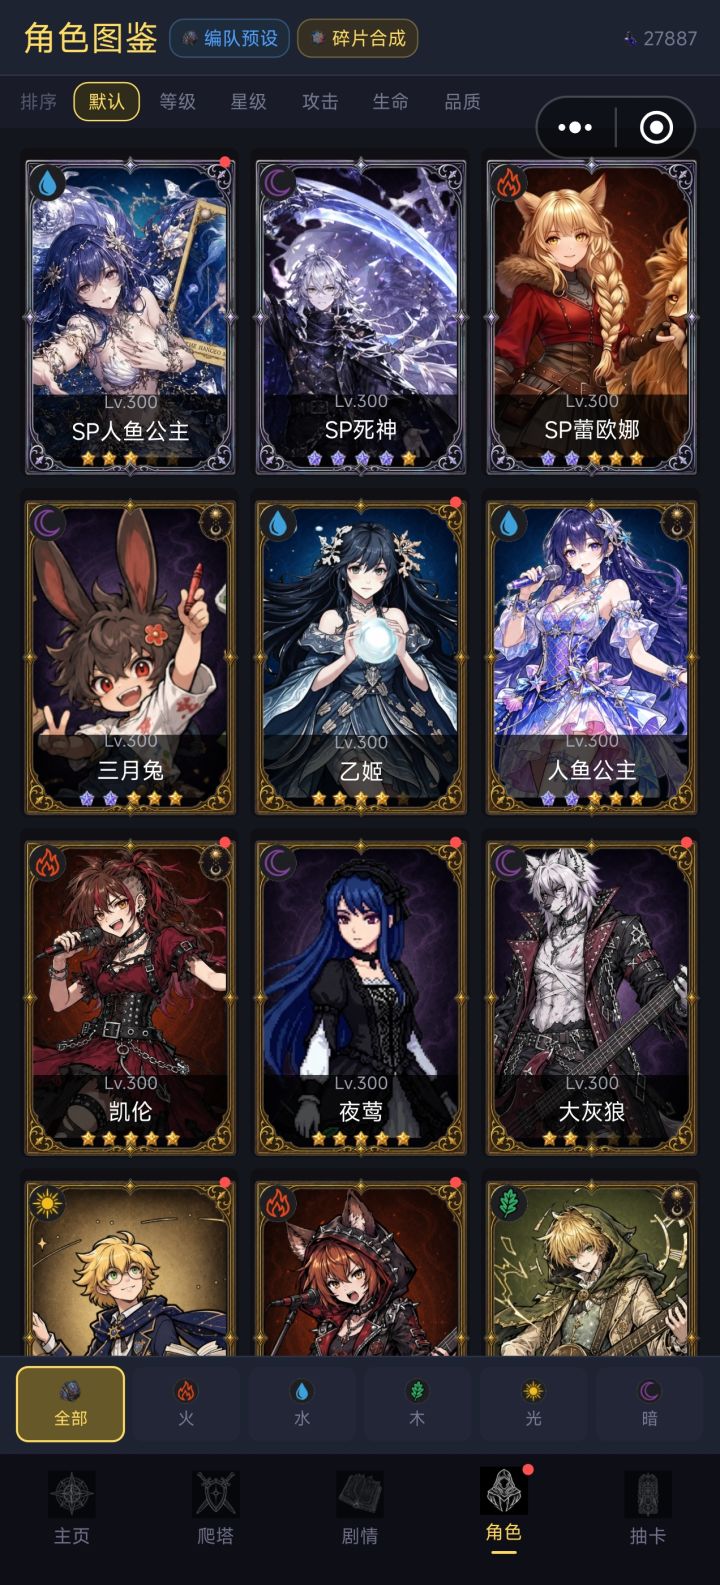
为了不被斩杀,我只能做到这些了
之前一直申请不到计划3,之前说太花哨,后面说体量完成度不足,在我一番小作文下,编辑终于给了我解答,什么原生质感,玩家开局体验啥的。
本来计划2也够用,准备以后再优化了,结果计划2赠送的积分要砍半了,学生党实在消费不起,于是只能再冲一波计划3了
从周六中午到现在一天半时间,优化了一遍角色卡,战斗卡,还有抽卡界面,优化了新手教程,该说不说确实比之前要舒服些。
前半部分为新版,后半部分为旧版。
明天再次
@才不是帅帅
37 赞
6 回复
01:27
《大二暑假,我用AI做了一款属于自己的游戏》
本人自制游戏现已加入taptap封闭测试(仅适配安卓机型)欢迎大家前来尝试(八月十号可以正式开始游玩)
如果有建议或者bug反馈可以加入qq群928501443
#发现好游戏 #游戏日常 #浅评一下 #今天游戏圈发生了啥
@多边形幸存者
3 赞
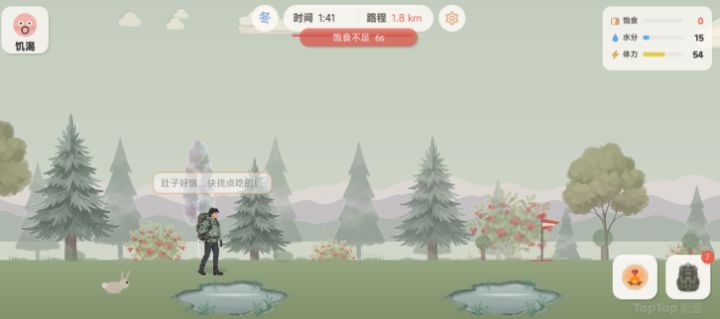
开发心得-界面布局心得
大家好,我正在用 TapTap 制造制作一款2D 治愈林间徒步旅行游戏《徒步荒野》。
我分享一下我的开发心得,希望能有用,下面是一些界面布局的心得。
第一步:定版式、操作
先确定游戏是横版还是竖版、需要哪些操作按钮,敲定整体玩法思路。
我的玩法灵感参考《边境之旅》,主打散步看风景、沿途触发随机事件。
原版是 3D,考虑到自己是新手,选择2D 横版街机式来做,制作更简单、好上手。
第二步:敲定全局美
@大圣
6 赞
3 回复
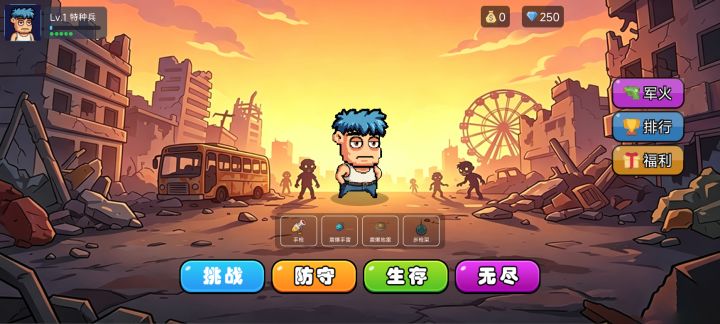
【游戏上新】——宅男打丧尸
这是一款横向俯视角射击生存游戏,主打"轻松上手、越玩越爽"的爽快体验。游戏目前已包含:
四种核心模式:挑战、防守、生存、无尽,满足不同玩家口味
多种枪械,从手枪到重型火力,打出自己的风格
地雷,手雷,枪架多种不同军火自由选择,给敌人造成最大伤害
完整的成长体系:角色等级、军火系统、被动技能,越肝越强
丰富的敌人设计:普通丧尸到多种 Boss,战斗层次感明显
未来会制作更多不同的角色,天赋,军火,玩
@青衫
4 赞
12 回复
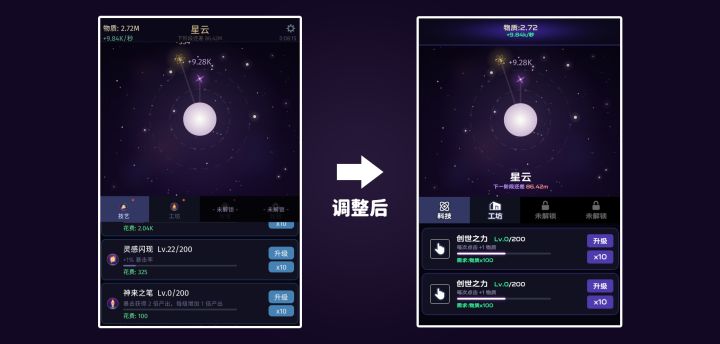
如何提升你游戏中的UI美术水平
一、请为你的游戏挑选一款合适的字体
很多开发者没有注意到其实UI界面中最重要的元素是字体,一款合适的字体能给整个游戏的界面感官带来蜕变。
请看案例
那么如何挑选适合自己的字体呢?
我总结出了一些小经验可供参考:
黑体:通用
宋体:古风、武侠、修仙
楷体:古风、武侠、修仙
圆体:卡通、动漫、Q版
科技:科幻、未来、电子
顺手分享一个免费可商用字体网站:
当然 如果你不知道自己的游戏适合什么风格
精华
@N3
123 赞
44 回复
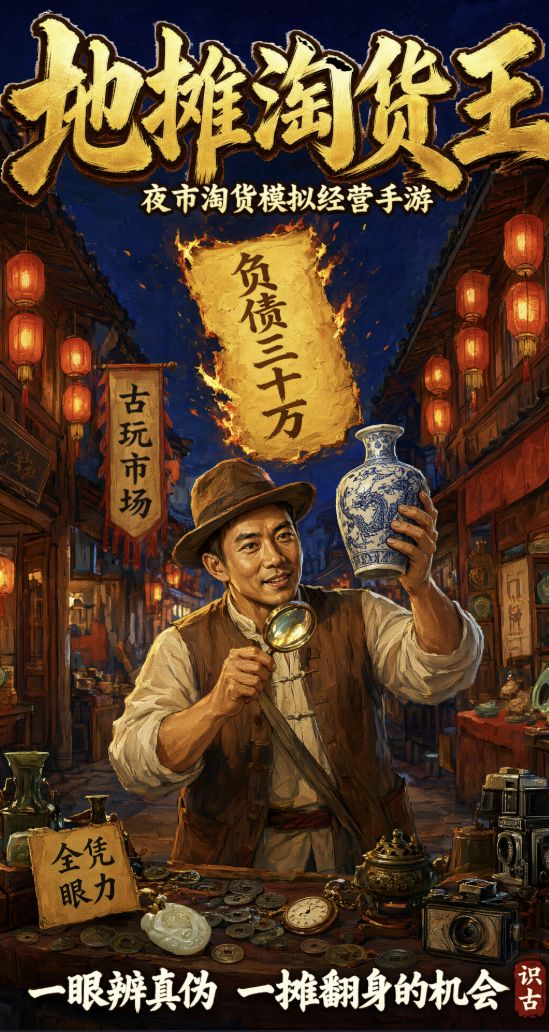
【跪求】《地摊淘货王》已经完成品质升级发布,求版大赐予推广👻
感谢版大和各位论坛好友的支持和鼓励,我最近终于完成了《地摊淘货王》的全面升级改造,从UI/UE到角色绘制、剧情编写,目前各项功能都已经自测通过,也已经成功发布,还请版大能赐予一些推广资源给游戏点曝光,也欢迎各位论坛朋友体验指正哈😊😊😊
@哑铃虫大王
4 赞
零基础做游戏⑨商店简介+开发者的话怎么写
同样的游戏,有的人简介看完直接下载,有的人看完直接退出。
前面1‑8期我们已经搞定:从零做游戏、修BUG、省积分、规避侵权、上架过审、封面截图优化,掌握了TapTap自然流量基础。
本期第九期:商店简介&开发者的话,决定玩家会不会点下载按钮。
很多开发者踩坑:封面截图已经做好,但是商店文案写得一塌糊涂。
玩家点进商店页,扫一眼简介,3秒内没抓住亮点,直接划走,再好的画面也白费。
两
@三国群雄志制作人—辰安
1 赞