
下载 App
《小巫大祸》开发日志:为了做这款游戏,我到底用了多少 AI?
大家好,我是安奈。
上一篇聊了《小巫大祸》为什么往 UE 搬,这篇想把镜头转到电脑这一边:做到现在,我究竟同时用了多少平台、多少模型,又投入了多少资源?
这次从最早的 D:/taptap 项目往回查,也把后来的 UE 迁移算进去。旧原型、推翻的方案、没被选中的素材和失败尝试,都属于这段开发过程。具体金额就不写了,聊聊这些资源到底用在了哪里。
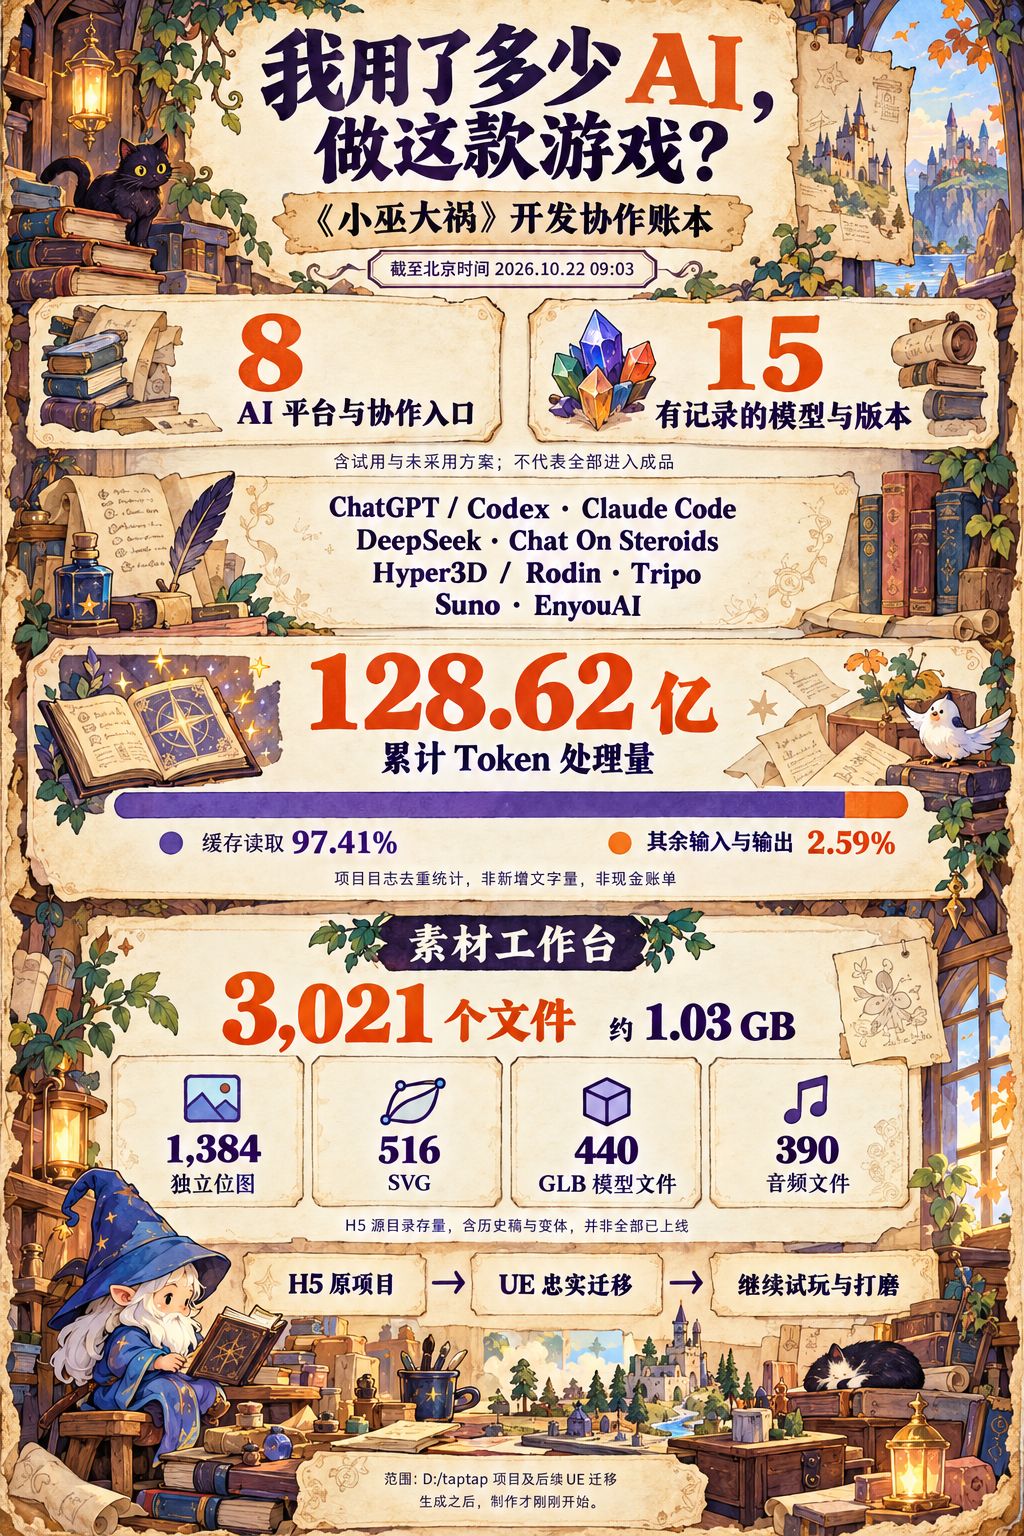
截至这次统计,可追溯到 8 个 AI 平台与协作入口、15 个有记录的模型标识或版本。这个数量包括试用后放弃的方案,不代表它们全部参与了最终成品,也不是同时开着这么多模型。
OpenAI 的 ChatGPT/Codex 和 Claude 参与了策划、代码、界面、测试和整合;DeepSeek 有地图与组件交付分工;Chat On Steroids 用来连接工作流和读取用量。美术制作里用过 Hyper3D/Rodin 和 Tripo,音乐用过 Suno,配音也试过 EnyouAI 聚合平台,后来转到本机 Qwen3-TTS。
我把 ChatGPT/Codex 合在一个生态入口里,也没有把 Blender、Three.js、UE 算成 AI 平台。它们是把结果做成游戏的制作工具。聚合平台也不等于一家新的模型厂商,所以这里统计的是实际用过的入口。
说起来像一支阵容很大的队伍,真正做起来却经常是很细碎的事情。
我得先决定游戏应该是什么样,再看它们交出来的东西哪里不对。角色技能不能只是换个颜色;职业核心不能挤进其他技能栏;召唤物不能只是站在那里;怪物走路也不能像几块积木在地上滑。然后改完,再打开游戏看一次。
工具多了,交接也变成了工作的一部分:谁改规则,谁做表现,谁把东西接进正式入口?这次看到的画面,到底来自新代码还是旧包?模型在预览里能动,进游戏后有没有真的播对动作?这些问题,比多开一个聊天窗口更需要耐心。
这次沿用上一篇的统计脚本,重新读取本机项目日志并按响应去重,得到的累计处理量约 128.62 亿 Token。
其中约 125.30 亿是缓存读取,占 97.41%;非缓存输入及缓存写入约 2.84 亿,输出约 4839 万。旧代码、长方案和上下文会反复进入模型,所以这个总量不是新生成的文字量,更不是我亲手输入的字数。它也不是账单,不能直接换算成花了多少钱。
这个统计覆盖本机能找到的项目日志,包括早期探索、旧方案、自动子任务、美术、排障、发布准备与 UE 迁移。其他项目没有混进来;图片、音乐、3D 和语音服务的独立用量,也不能靠这份聊天统计补齐。
更直观的投入,其实藏在素材目录里。
现在 H5 主项目的 spell/public 下有 3,021 个文件,约 1.03 GB。其中有 1,384 张独立位图、516 个 SVG、440 个 GLB 模型文件、390 个音频文件。
这里面有不同版本、历史稿和尺寸变体,也有程序制作和第三方资源。它不是“做了 440 个完全不同的角色”,也不是玩家每次打开游戏都要下载 1 GB。正式发行包会有单独的裁剪与核对;这些数字更像是工作台上积累下来的材料。
到了 UE 阶段,召唤物这边又有了 32 个成长阶段模型导出包。但导出只是中间一步:有的需要补绑定,有的动作会拉坏局部轮廓,有的材质还要放进引擎里重新看。能下载模型,和能在战斗里自然地跑起来,隔着不少工作。
配音也是这样。之前我试过云端预置音色,听完还是觉得太假、不像这个白胡子老巫师,于是放弃那批试听,转到 RX 7900 XT 上跑本地 Qwen3-TTS。后面继续一句句调整语气、停顿和反应,用 Whisper 辅助检查,再回到实际试听。换成本地生成,仍然需要算力、时间和反复挑选。
还有一部分投入,很难用文件数表示:模型生成后返工,动作做好后重绑,代码通过局部测试后继续查整合问题,以及我自己一遍遍试玩、推翻和重新选择。这些尝试不会全出现在玩家面前,但都会占用开发时间。
这次统计里,我也把转向 UE 的那一段单独留下来了。
H5 是《小巫大祸》真正长起来的地方。四职业的方向、元素反应、成长选牌、界面和试玩反馈,都是在这个项目里一点点磨出来的。现在转到 UE,我希望桌面版能有更完整的模型、材质、动画和战斗表现,也希望这些升级能建立在原有玩法之上。
所以,我没有直接拿 UE 工程覆盖 H5。D:/taptap 保留原项目,D:/XiaowuUE 单独推进迁移。迁移要对着选定的 H5 版本核对:同一个技能该怎么命中,召唤物该听什么指令,符阵怎么变化,选牌和存档能不能保持原有规则。
目前先集中做 M00 首图的完整四职业。新地图和跨关扩展暂停,已经认可的 UE 美术尽量保留。目标很具体:打开游戏,选一个职业,打一局,成长、存档、继续,到最后结算,这条流程要接得起来。
这一阶段的协作也有变化。Codex 负责当前迁移统筹与分域接线,Claude 有前期宿主、构建和资产整合交接;DeepSeek 的地图与组件成果按来源保留,人物与召唤物沿用 Tripo 的交付,再经 Blender 修整和导出,最后进入 UE。不同工具的成果必须在同一个可运行版本里相遇,才算真正接上了。
四位主角已有模型与动作交付,召唤物目录里有32个成长阶段模型包;局部还有蒙皮拉伸、动作衔接和材质需要继续处理。旧客户端样板有编译、打包和原生运行证据,新一轮忠实迁移也已有编辑器构建通过及局部规则、事务测试。它们属于不同批次,不能拼起来宣称“最新四职业完整版已完成”。
现在仍要继续做的是四职业权威规则与宿主整合、输入和成长流程、存档事务,以及同一版本上的原生试玩、画面、听感和性能检查。UE 给了我更大的表现空间,也让我更清楚地看到:模型和代码各自完成之后,整合仍然是一大段制作。
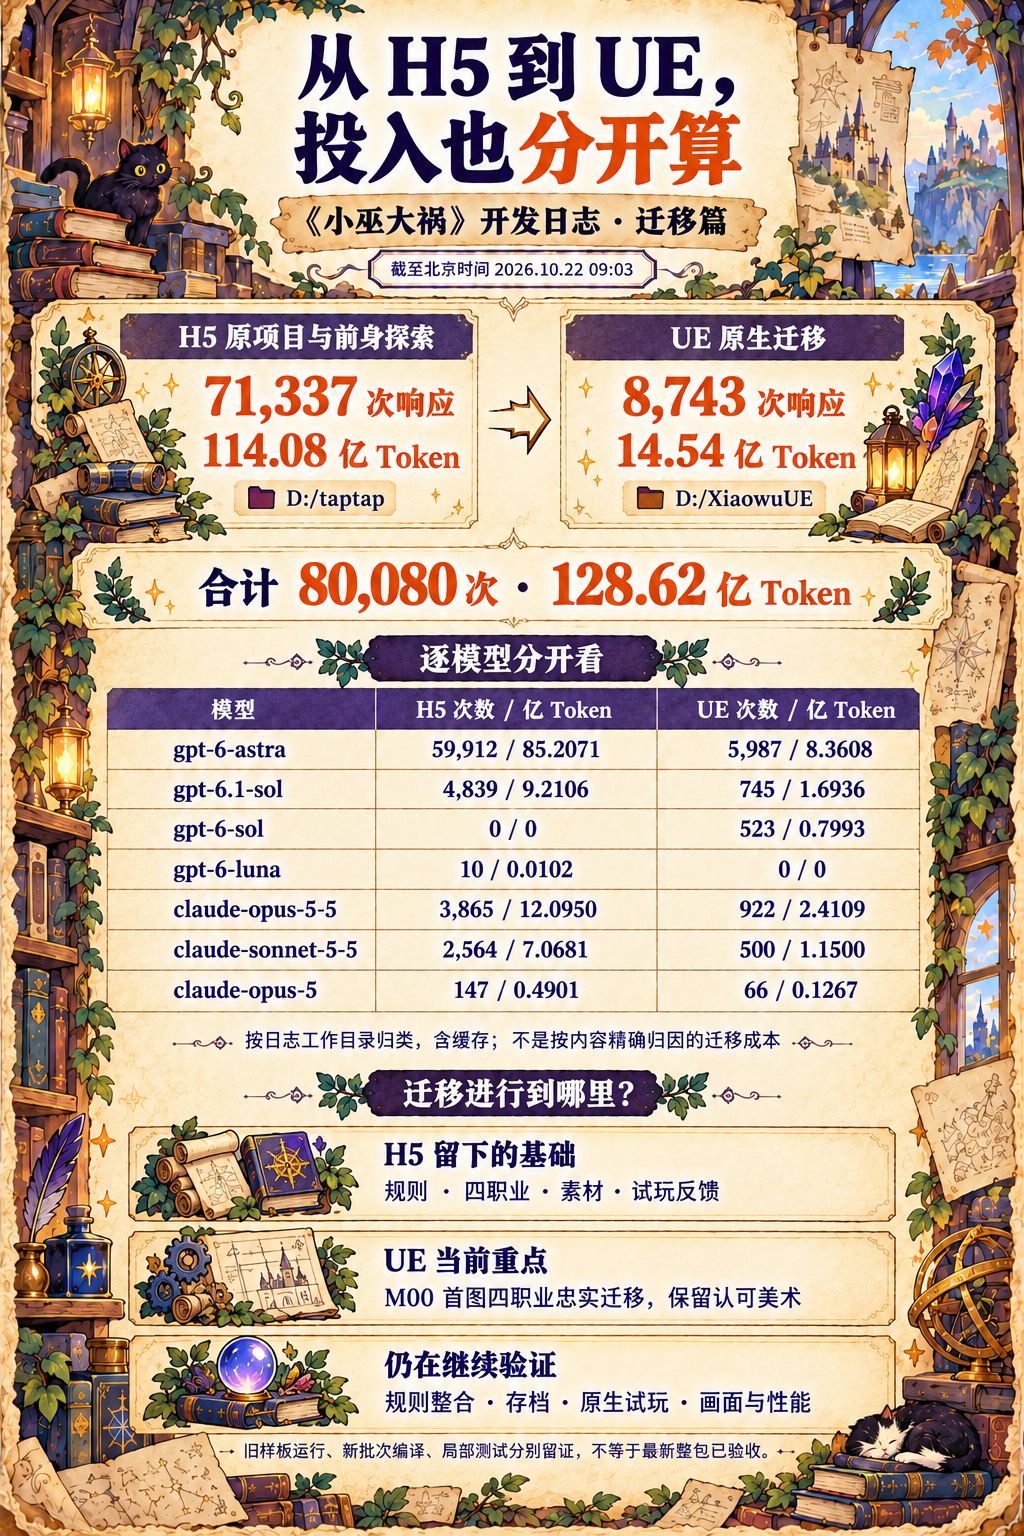
单独拆开看,H5项目目录及前身探索记录为71,337次响应、约114.08亿Token;UE迁移目录为8,743次响应、约14.54亿Token。两部分相加就是本次累计的128.62亿。
下面的H5/UE用量表按日志所属工作目录归类。早期在H5聊天里讨论迁移的内容仍可能落在H5列,因此它是“目录归属统计”,不是逐句语义判断出来的迁移成本。
我想让下一次日志少一点“又增加了多少东西”,多一点可以实际感受到的变化:技能释放更清楚,召唤物更像伙伴,选牌真的改变打法,存档回来后还能顺畅地接着玩。
如果你也在用 AI 做游戏,欢迎聊聊你最费时间的是哪一步。对我来说,生成出来以后,往往才刚刚开始。
——安奈,2026 年 10 月 22 日
统计截止:2026-10-22 09:03(北京时间 UTC+8)。主线为 D:/taptap 项目及其 UE 迁移,包含前身原型和未采用方案;数据来自本机现存记录及素材目录,不公开原始聊天与具体金额。本作开发与本文整理使用 AI 辅助。
附:逐模型统计
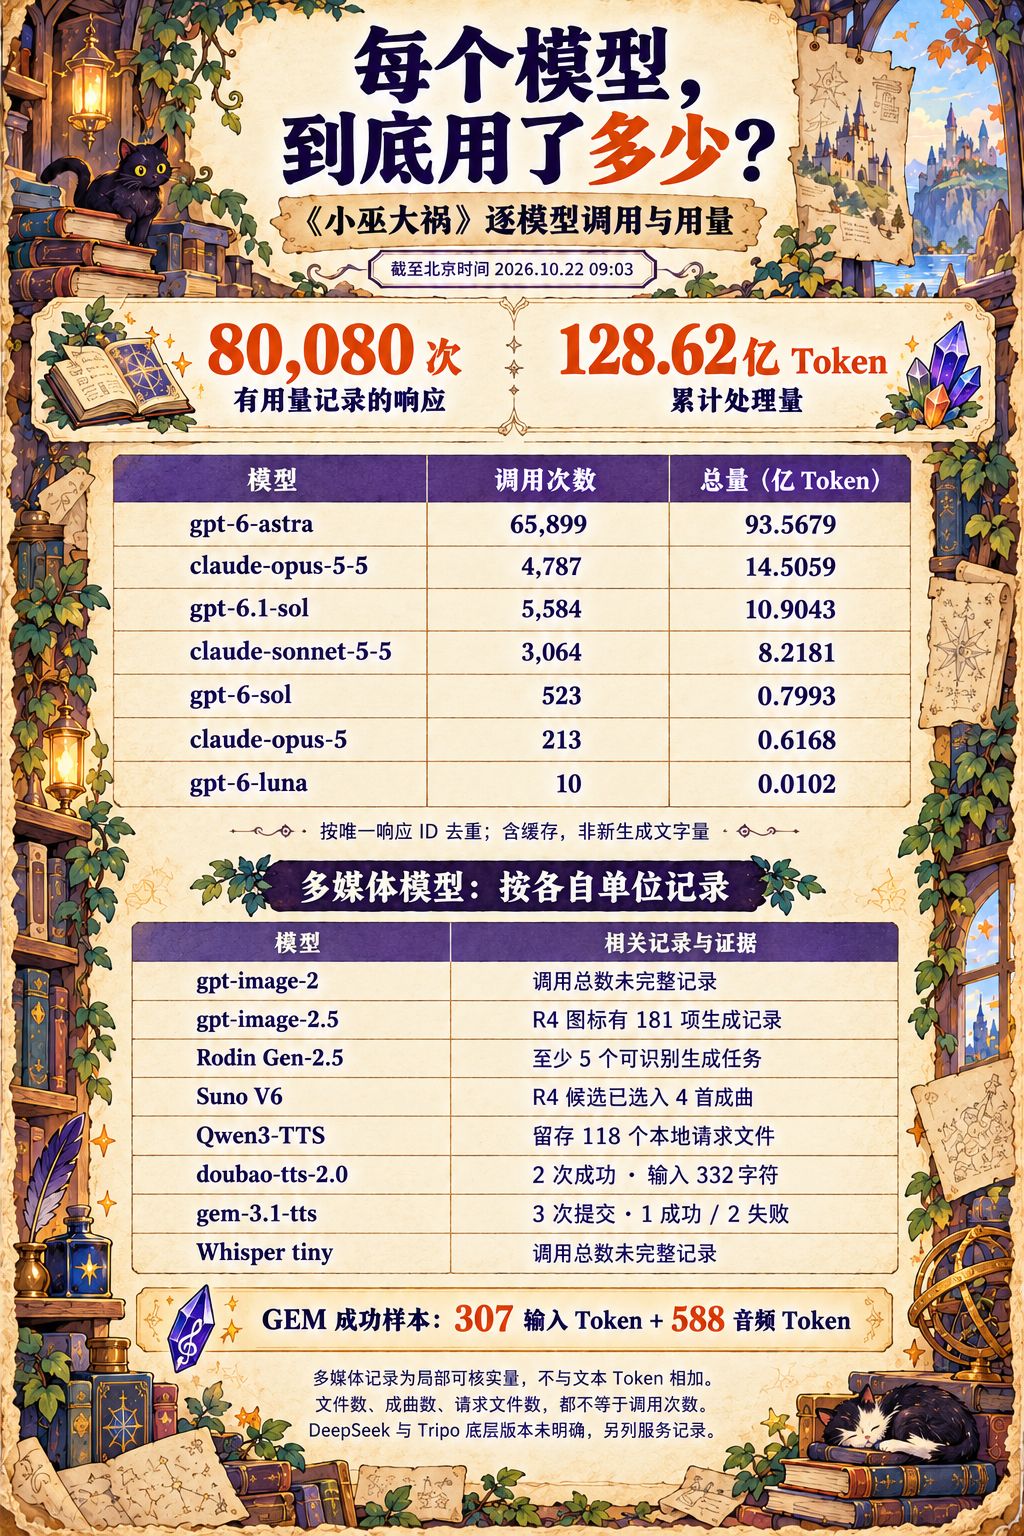
截止北京时间2026年10月22日09:03。项目范围:D:/taptap及后续UE迁移,含前身、废案、自动子任务。调用次数按带usage的唯一响应/消息ID计数,不是用户提问次数,也不包含无usage的失败HTTP尝试。
| 模型标识 | 调用次数 | 输入Token(含缓存) | 其中缓存读取 | 输出Token | 总Token |
| gpt-6-astra | 65,899 | 9,319,982,908 | 9,112,596,224 | 36,805,966 | 9,356,788,874 |
| claude-opus-5-5 | 4,787 | 1,446,580,256 | 1,425,019,062 | 4,011,132 | 1,450,591,388 |
| gpt-6.1-sol | 5,584 | 1,085,492,416 | 1,056,377,472 | 4,933,311 | 1,090,425,727 |
| claude-sonnet-5-5 | 3,064 | 819,626,483 | 802,670,053 | 2,188,182 | 821,814,665 |
| gpt-6-sol | 523 | 79,598,817 | 77,115,008 | 326,685 | 79,925,502 |
| claude-opus-5 | 213 | 61,562,182 | 54,799,202 | 119,347 | 61,681,529 |
| gpt-6-luna | 10 | 1,020,095 | 953,984 | 2,262 | 1,022,357 |
合计:80,080次有用量记录的模型响应,12,862,250,042 Token。另有65条<synthetic>系统合成记录,用量均为0,排除出模型调用数。输入已经包含缓存,不要再次相加。7个模型全部按turn_id关联或消息model字段识别,未识别模型0,读取错误0,逐模型总和与总账完全一致。
图像、3D、音乐、语音与转写
下表是当前可查证的局部用量,不与文本总账相加。“未完整记录”不代表没有调用,也不等于0。平台任务、留存请求、产出文件是不同口径。
| 模型/服务 | 调用次数 | 已核实使用量或产出 | 边界 |
| gpt-image-2 | 未完整记录 | Logo等生成/编辑有来源记录;累计图像Token未上报 | 不能从图像变体数反推调用数 |
| gpt-image-2.5 | 未完整记录 | 仅R4图标进度表就有181项明确标注该模型的生成记录 | 181项是局部产出记录,不是全项目调用次数 |
| Rodin Gen-2.5 | 至少5个可识别生成任务/资产ID | R12头部1项;R13帽、靴、包、杖4项 | 不含未收齐的其他候选及重试;积分总量未完整记录 |
| Suno V6 | 未完整记录 | R4封存候选披露4首已选成曲 | 4首不等于4次调用,不代表当前主工作区目录已包含 |
| Qwen3-TTS 1.7B CustomVoice | 未完整记录;留存118个本地请求文件 | 140句主角去重台词的制作批次,另有其他角色与重录 | 请求文件含PENDING,不把118当成功调用数;未形成完整算力/时长总账 |
| doubao-tts-2.0 | 2次提交,2次成功 | 两次各166字符,共332字符输入 | 平台字段名input_tokens,此服务实际按字符;输出token字段为0不等于没生成音频 |
| gem-3.1-tts(平台别名) | 3次提交:1成功、2失败 | 成功任务输入307 Token、输出588音频Token,对应23.52秒 | 2次失败保留;成功音色后来未被采用 |
| Whisper tiny | 未完整记录 | 用于试听转写与分句辅助 | 累计音频时长/调用数未形成完整账本 |
| DeepSeek(版本未明确) | 未完整记录 | 有地图与组件交付分工 | 后续CLI缺凭据的一次尝试没有推理;不计进15个已知版本 |
| Tripo(底层版本未明确) | 未完整记录 | 当前UE召唤物目录32个成长阶段ZIP;另有主角交付 | ZIP不是调用次数;网格/纹理/绑定可能多次调用;不计进15个已知版本 |
统计仅公布汇总,不公开原始聊天和具体金额。模型名称按本地日志或平台记录标识列出。
H5原项目与UE迁移分开统计
截至北京时间2026年10月22日09:03,按日志所属工作目录归类。早期在H5目录聊天中讨论UE迁移的内容仍归H5,不是精确按内容归因的成本。两栏构成累计总量,不重复计费、不公开金额。
| 模型 | H5响应次数 | H5总Token | UE响应次数 | UE总Token |
| gpt-6-astra | 59,912 | 8,520,711,848 | 5,987 | 836,077,026 |
| gpt-6-luna | 10 | 1,022,357 | 0 | 0 |
| gpt-6.1-sol | 4,839 | 921,064,038 | 745 | 169,361,689 |
| gpt-6-sol | 0 | 0 | 523 | 79,925,502 |
| claude-sonnet-5-5 | 2,564 | 706,811,394 | 500 | 115,003,271 |
| claude-opus-5-5 | 3,865 | 1,209,497,058 | 922 | 241,094,330 |
| claude-opus-5 | 147 | 49,008,908 | 66 | 12,672,621 |
| 合计 | 71,337 | 11,408,115,603 | 8,743 | 1,454,134,439 |
0表示该目录归属的本地记录未观察到调用,不代表该模型在其他地方从未使用。
00:46
《小巫大祸》开发日志:小巫搬进 UE 了,最近在忙这些
最近12小时,《小巫大祸》在做一件挺大的事:把原来的 H5 版本搬到 UE 里。
角色、场景、动画,这些变化比较容易展示。换个画面,截一张图,就能看出区别。但这段时间真正花精力的,是那些截图里看不出来的东西。
比如,换了引擎,同一招打出去,还是原来那一招吗?
水面上的电,究竟是在参与战斗,还是只是看起来很热闹?一次升级选完,能力有没有真的变?退出以后再回来,这一局还记不记得我刚才做过什么?
这些问
@安奈
1 赞
《小巫大祸》开发日志:我们开始转 UE 了!
从昨天开始《小巫大祸》有一个挺大的变化:我们开始把游戏往 UE 客户端方向迁移了。
做这个决定,最直接的原因是,我对现在的战斗流畅度和画面质感还不够满意。前面的版本让很多想法真正跑了起来,但越往下做,越希望人物动作更自然,法术打出去更有反馈,场景和怪物也能撑得住近看。
我想把它继续做成一款值得花时间玩的游戏,所以这次决定把客户端版本认真做起来。当然,换引擎不会自动让游戏变好,动作、材质、特效和性能
@安奈
4 赞
01:05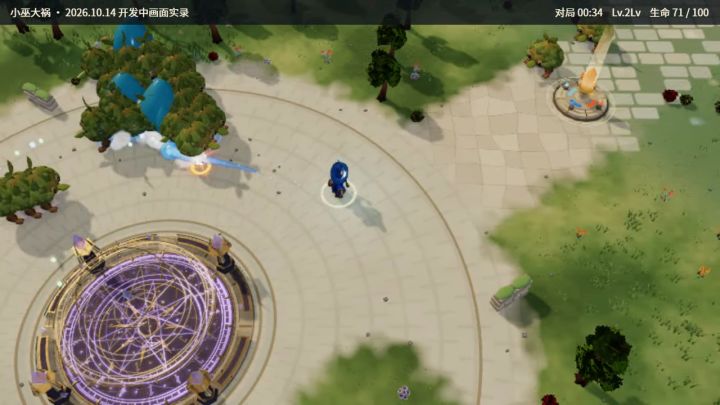
《小巫大祸》开发日志01:第一次,一个人做游戏
大家好,我是《小巫大祸》的开发者。这次想跟大家聊聊,这几天我到底在折腾什么。
这是我第一次做游戏,目前由我一个人独立开发。
玩法、画面、试玩、修改,都在边做边学。开发中也用到了 AI,帮我写代码、梳理策划和制作部分素材。但游戏最后好不好玩,还是得自己一遍遍打开来试。
做着做着,我发现自己最该问的,已经从“还能加点什么”,变成了“现在这些东西,真的好玩吗?”
10 月 12 日,我确定了现在这个方向
@安奈
01:37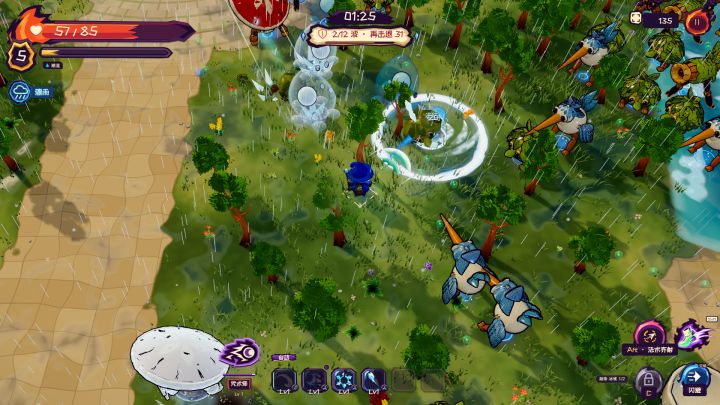
《小巫大祸》开发日志06:小小选择,连锁大祸
大家好,我是安奈。又来交一份《小巫大祸》的开发作业。
这几天忙着改职业、补表现、录实机,也终于把这一轮的包体传上了 TapTap。中间还碰上了一次上传解析失败,来回检查了一圈。比起“终于传上去了”,我更想聊聊这次做游戏时反复问自己的一个问题:今年聚光灯 GameJam 的主题是「涌现」,那玩家究竟在哪里能感受到它?
最先想到的当然是元素反应。地上的水、火、油,碰上不同法术,就会把一块普通地面变成机
@安奈
4 赞