
下载 App

《AI 进化》开发者日志 01:把三代棋类 AI 装进一款游戏
4 小时前6 浏览综合
2026.10.16 | 规则是简单的,智能是长出来的
大家好,我是《AI 进化》的开发者。这是这个项目的第一篇开发者日志,也是最后一篇。
看到本届聚光灯 GameJam 的主题「涌现」时,我脑子里冒出来的第一个画面不是康威生命游戏,而是棋类 AI 这几十年走过的路。先说五子棋本身:一张 15×15 的棋盘、一条"五连即胜"的简单规则,却能从中长出做棋、诱堵、连环冲四的 VCF/VCT 杀法,还有一代代玩家攒下来的开局定式——规则只有一句话,战术却是自己长出来的。再把 AI 也放进这套简单规则里,让它自己和自己下棋,长出来的东西就更有意思了(这个我们留到第三代讲)。
于是选题就这么定了:做一款让玩家亲手"调教 AI"的游戏,把棋类人工智能发展的三个时代,做成玩家可以亲自走一遍的三个阶段。
这篇日志想讲清楚三件事:游戏是什么、三个阶段在技术上分别是真是假、以及我是怎么把一个刚刚训练好的神经网络塞进手机里的。
一、三代棋类 AI:从人写规则,到网络自己长出来
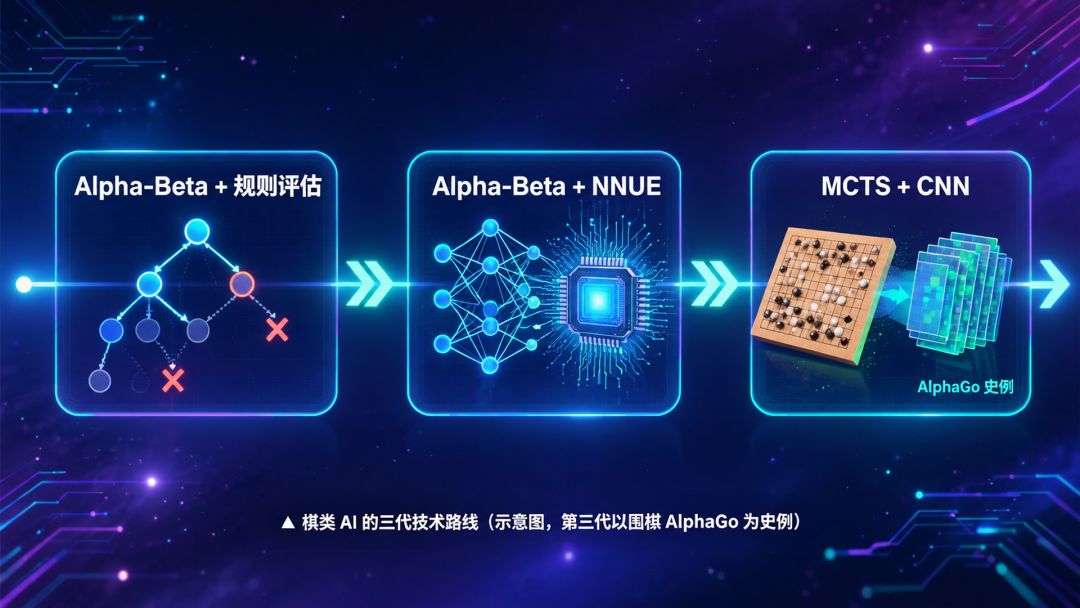
棋类程序的历史,恰好就是一条"人类知识逐步退场、智能逐步涌现"的线:
第一代:Alpha-Beta 引擎 + 规则评估。 程序负责暴力搜索(极大极小 + Alpha-Beta 剪枝),而"什么样的局面好"由人类专家手写:活二多少分、活三多少分、冲四要不要堵。这是从深蓝到无数民间五子棋/象棋引擎的经典路线,强,但它的上限就是写评估函数那个人的棋力上限。
第二代:Alpha-Beta 引擎 + NNUE。 搜索框架不动,把人类手写的评估函数换成一个小神经网络,让网络从百万局棋谱里学会打分。NNUE 最早在将棋领域一战成名,随后进入国际象棋,引发过一轮引擎大换血,老牌名引擎纷纷靠它把棋力又抬上一个台阶。这股风后来也吹进了五子棋——如今顶尖的开源五子棋引擎同样以 NNUE 评估为核心,拉开了与纯手工评估引擎的差距。游戏里的阶段 2,致敬的正是这条路线。
第三代:MCTS + CNN。 这一次连搜索框架也换了:蒙特卡洛树搜索负责推演,卷积神经网络同时给出"该往哪下"(策略)和"这盘能不能赢"(价值),而网络的老师不再是人类棋谱,而是它自己——不断自我对弈、自我迭代。
这条路最早是在围棋上被全世界看见的:2016 年 AlphaGo 击败李世石,对局中甚至下出了人类围棋千年经验里从未有过的招法;此后的 AlphaZero 不看一局人类棋谱,仅凭自我对弈就横扫了围棋、国际象棋和将棋。
这里必须替围棋和五子棋划清界限:它们是两种完全不同的棋——围棋在 19×19 棋盘上以围地多少论胜负,五子棋在 15×15 棋盘上五连即胜,棋理并不相通,AlphaGo 的网络也不能拿来下五子棋。但在工程层面,MCTS+CNN 是一套"与棋种无关"的架构:网络看到的只是棋盘状态张量,输出的只是每个落点的概率和局面前景,换一套规则、换一批自我对弈数据,同一套算法就能搬到另一张棋盘上;五子棋棋盘更小、一局更短,跑起来反而更轻快。AlphaGo 向世界证明了这条路能走通,而我手上刚训练完的这个模型,就是同一条路在五子棋上的复刻。
需要说明的是,第二代和第三代在真实历史里基本是并行发展的,并没有严格的先后。之所以在游戏里排成 1→2→3,是因为沿着"人类写规则 → 网络学评估 → 网络学一切"这条主线看,MCTS+CNN 走得最远、最彻底:它连"该看哪些特征"都不需要人告诉它,一切从棋盘和胜负里自己涌现。
更妙的是,手边正好有这么一个刚训练完的五子棋模型——意味着游戏的第三代不只能停留在叙事上,还有机会让玩家摸到真东西(详见第四节)。于是,《AI 进化》就这么开工了。
二、游戏是什么:你不是棋手,你是 AI 工程师
《AI 进化》是一款的"AI 训练模拟"游戏。玩家扮演一名五子棋 AI 工程师,核心循环是:
调参 →(模拟)训练 → 评测 → 亲自下场自测 → 再调参
游戏对应上面的三代技术分成三个阶段,每个阶段的"外观"都不同:
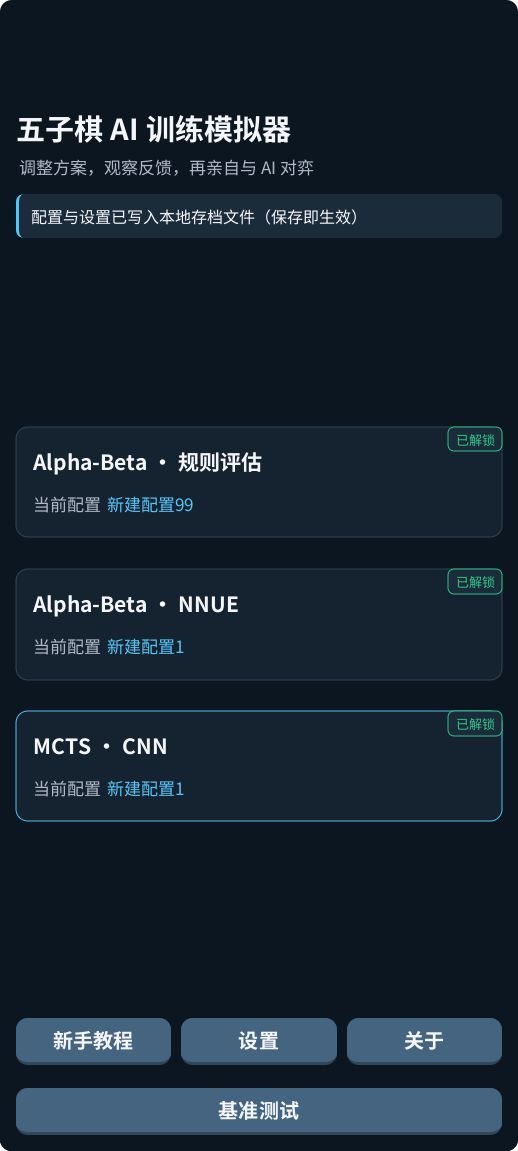
- 阶段 1 · Alpha-Beta + 规则评估:直接调引擎参数——搜索深度、思考时间、候选着法宽度,以及活二、活三、冲四、活四等各棋型的评估权重,共三十项,全部真实生效。
- 阶段 2 · Alpha-Beta + NNUE:外观变成调"隐藏层大小、学习率、数据量、训练轮数",观看训练曲线的起起落落。
- 阶段 3 · MCTS + CNN:外观变成调"模拟次数、探索常数、网络规模、自对弈局数、温度"。
阶段 2、3 的"训练"在手机上是模拟的——在手机里训练神经网络基本做不到。所以调参和训练阶段是拟合模拟玩法,由于手上只有MCTS+CNN的模型,所以这个阶段玩家得到的是由调参和训练阶段所拟合的MCTS+CNN模型的不同配置。
三、阶段 1:一套真材实料的高性能 Alpha-Beta 引擎
阶段 1 是整个游戏的根基,也是内容最"硬核"的部分。游戏内置了一套从零手写的高性能五子棋 Alpha-Beta 引擎,不是玩具:
- 迭代加深 + 时间限制双预算,想深就深、到时就停;
- 渴望窗口(Aspiration Window)、静态延伸、后期自动降深;
- Zobrist 置换表跨步复用、历史启发等多级着法排序;
- 增量式棋型评估,以及独立的 VCF/VCT 连续冲四杀棋搜索。
玩家在工作台上调的每一个参数,都会真实改变这个引擎的思考方式和棋力。你可以把活三权重拉满,养出一个嗜攻的疯子;也可以加厚搜索深度,养出一个迟钝但难缠的防守派。调完之后有两条反馈回路:
- 自测:亲自下场和自己的配置下一盘。盲调是没有意义的,你得先被自己的 AI 虐过,才知道参数错在哪。
- 评测:你的配置对战"官方参数",或对战自己的上一个版本的参数,能让你对参数的理解更加深刻,使得最新版本的参数不断进步。
围绕这套真引擎,首发版本的核心玩法会放在四件事上:调参、自测、排行榜,以及玩家之间的"电子斗蛐蛐"——双方各自掏出自己精心调整的参数配置,让两台 AI 在棋盘上真刀真枪干一场,你只需要端着瓜子看你的"蛐蛐"给不给力。同一份规则、同一套引擎,配置的细微差别会自己涌现成完全不同的棋风和胜负。
四、阶段 3 的"彩蛋":我把刚训练完的模型蒸馏后塞进了游戏
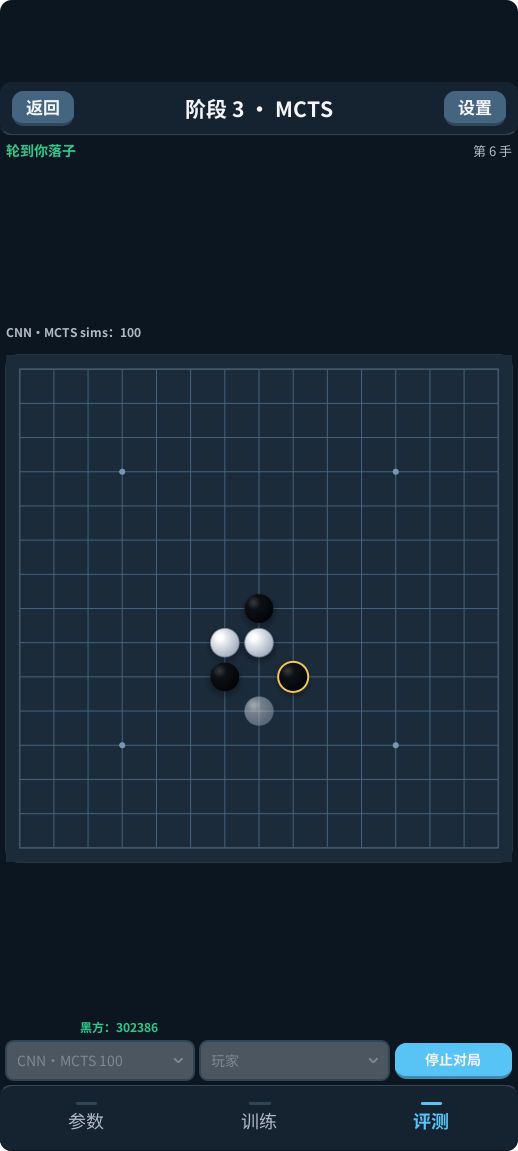
按最初的设计,阶段 3 的 MCTS+CNN 和阶段 2 一样只是叙事外观。但我毕竟手头真有一个刚训练完的五子棋 MCTS+CNN,不把它请进来总觉得可惜。于是有了游戏里这个"半公开的秘密":除了模拟训练,你还能在自测里选择真实的 CNN·MCTS 档位作为对手。
这件事的难点完全在手机端。引擎运行环境是纯 Lua(WASM 网页),没有任何神经网络推理框架,所有卷积都要逐标量手算。我的"老师模型"是 32 通道 × 5 残差块的策略价值网络,自测单次前向在真机上要 336ms——而 MCTS 每走一步需要数百次网络评估,一步棋算三分钟,完全不可行。
解决办法是知识蒸馏:让老师模型自对弈采样,把它的策略和价值判断教给一个小得多的"学生模型"。经过几轮实验(8ch×2res 的初代学生太小、棋力崩得厉害),最终选定的结构是:
12 通道 × 3 残差块 + 64 维价值头
- 参数量约 6.7 万,权重文件仅 263KB(老师模型的零头都不到);
- 单次前向约 2.2M MAC,真机纯 Lua 推理压到了几十毫秒级;
- Python(PyTorch)与游戏内 Lua 前向做过逐数值比对,误差在 1e-6 量级——同一份权重,两边算出来的答案一致;
- 配合纯 Lua 移植的 MCTS(根节点狄利克雷噪声、访问次数选点、搜索树跨手复用),终于能在手机里完整跑起"卷积网络评估叶子 + 树搜索"的真循环。
代价也如实相告:小模型的棋力相比它的老师有可见的下降,容量差距摆在那里,这是为"能在手机上真实运行"付出的门票。但它的每一步棋仍然是网络和搜索现场算出来的,不是脚本、不是棋谱——你面对的确实是一个会下棋的神经网络,只是它还没长大。
五、进度与上线计划
目前游戏的三阶段调参循环、真实 Alpha-Beta 引擎、评测对手池与自测对局均已跑通,蒸馏小模型与纯 Lua MCTS 也已在真机完成数值验证和性能冒烟。接下来的工作重心是打磨首发版本的四块核心体验:游戏内皮肤外观、调参、自测、排行榜、玩家配置对战(电子斗蛐蛐)。
预计发布时间:10 月 18 日~19 日之间。
我自己最期待的画面,是排行榜上两个我从未预想过的参数配置杀进顶点,然后下出一手我看不懂的棋——那大概就是"涌现"这个主题,能给一个调参游戏最好的注脚。
我们上线见!

00:39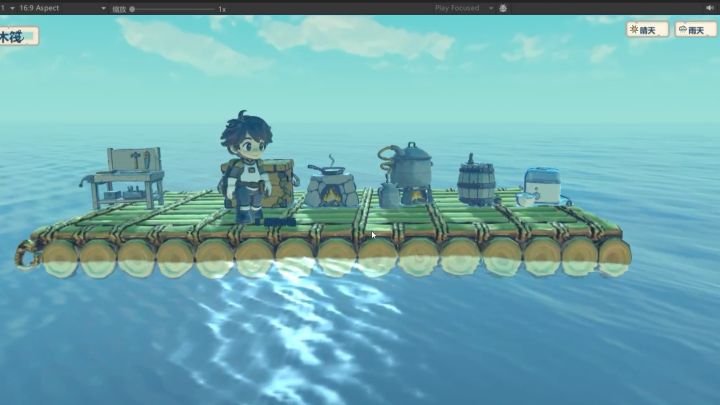
【开发日志3】主场景与玩法无缝化衔接
大家好我是鸭。这里是墨江里的一群鸭,嘎嘎嘎~
今天主要时间用来搭建主场景了,感觉有点浪费时间啊……理论上来说要进入到搜打撤玩法的unity场景搭建了。
不想打字了,大家看看画面表现效果吧~
#TapTap聚光灯独立游戏
@墨江鸭鸭
10 赞
1 回复
【Dimensional Emergence】开发者日志•4
在深思熟虑后我们放弃了做第二关贪吃蛇的部分,专注打磨好第一关的俄罗斯方块,但不代表我们现在的系统复用性很低。
开发进入到中期,基础的关卡部分已经完成,但我们不满足于此。
一个好游戏虽然不能有太多明显引导,但也不能失去基础的引导。至少要让玩家能够意识到要怎么玩。
我的设计能力还有所不足,只能暂时借助文字去阐述游戏规则。
好的引导就像是泰拉瑞亚和我的世界,这是稿子,这是斧子,这是箭与弓,去创造属于你的
@魔法老头
1 赞
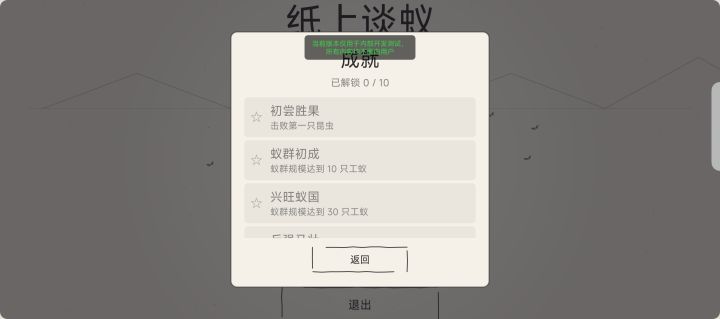
【开发者日志5】纸上微观世界的演化
各位独立游戏圈的前辈和同好们,大家好。
又是业余慢慢磨的一段时间。继上次把昆虫生态和战斗系统跑通后,这段时间我没有急着去铺跨纸的大摊子,而是静下心来,把现有的单纸体验扎扎实实地填了填肉——加了成就、引入了背景音乐与游戏介绍,并重点调试了“信息素”等核心交互逻辑。眼下的这个版本,终于让这张草稿纸有了一个相对完整、能自我运转的生态闭环。
【本期进展:从干瘪的框架到有声音、有反馈的纸面社会】
1. 信息
@努力努力再努力
1 赞
《涌泉物语》开发日志3
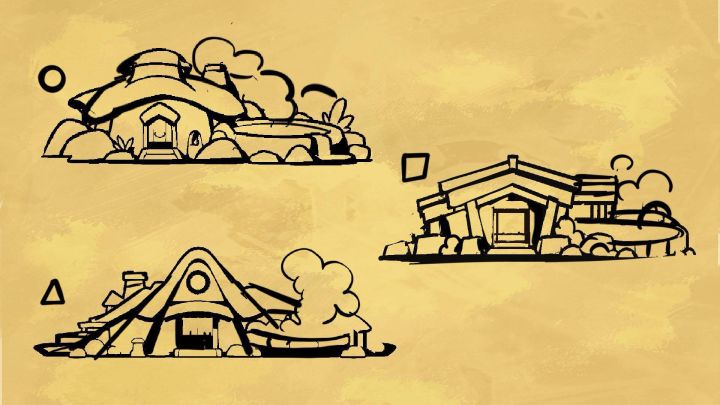
在固定整体风格与流程后,我们便将重心放在了美术上,首当其冲的便是游戏的整体环境背景。
在草图的设计中,出于对温泉浴场的考量,场景整体更偏向于乡村中式,但不久便发现乡村中式与背景故事中的现代大巴相性极差,遂将视角转向了架空小镇。
而在建筑风格外,如何与策划案中的功能相对照也成了新的问题。在最初的设想中,整个小镇有四个状态——最初的枯黄主色调,绿意微显、色彩渐浓与绿意盎然。但很显然,对于game ja
@杨戬火龙果
1 赞
1 回复
蜡忆余彩:开发日志【01】一张“灵魂涂鸦”是怎么被美术救活的?
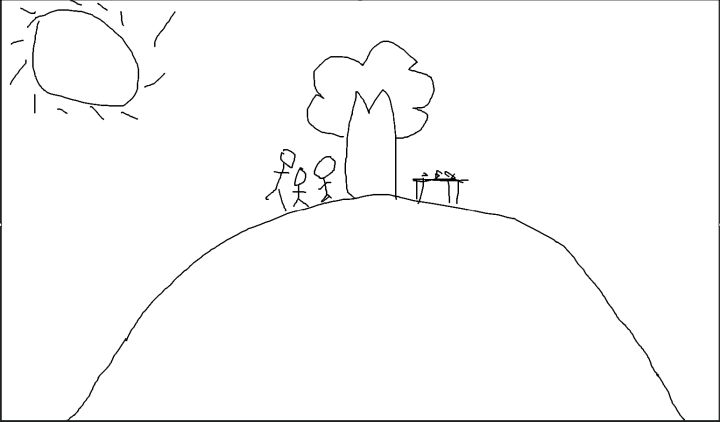
最开始,我们只是想做一张“小孩子画的画”。结果我给美术发过去的第一版,大概长这样【p1】
【p1】
嗯。太阳,大树,三个火柴人,还有一张不知道为什么像烧烤架一样的桌子。
从绘画水平上来说,确实非常符合“儿童画”这个要求哈哈哈哈哈哈。
但这张看起来非常随便的草图,其实后来变成了我们整个游戏里最重要的一件道具。
这张看起来最简单的画,后来反而成了我们整个游戏里最不能随便画的一张图。
因为它不只是场
@1wuyue
31 赞
16 回复
微观纪元开发者日志·肆
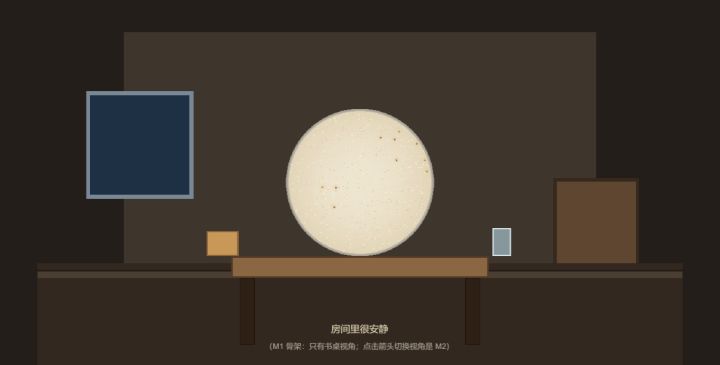
策划交了新版《微观纪元》玩法机制。读完的第一反应是:这不是改数值,是换地基—— 时间体系从"只有帧"变成"有天"、困意从进度条改成 6 个整数格、事件排程从定时器改成按天分时期、 温度与湿度的速率单位从"每帧"改成"每秒"。内核冻结了两轮之后,今天解冻重做。
六个阶段:时间与困意 → 事件按天 → 结局与优先级 → 交互层 → UI 与演出 → 同步配平出包。
最有意思的一件事:一个只有跑真实产物
@Jojo
1 赞
00:10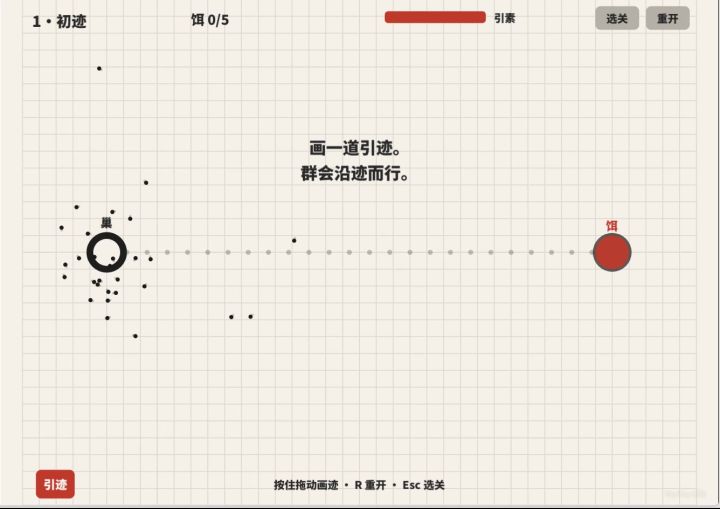
群迹·上取其下,下取其上
#聚光灯gamejam开发者日志
向大家汇报一下今日进度,目前在和蚁群的默认移动算法进行斗智斗勇。或许是我的AI对蚂蚁有别样的理解,其实最初写出的方案更接近于围绕着恒星公转的行星。
哦我还以为文章里可以插入多支视频视频,想要展示一些其它的运动方式,可惜了。那么就简单在上方传一个比较典型的,有点类似于蟑螂的运行方式。
目前仍在解决蚁群的随机运动,和玩家可操纵性之间的平衡问题。以及如各位所见,目前的
@孤叶 带寒
3 赞
1 回复
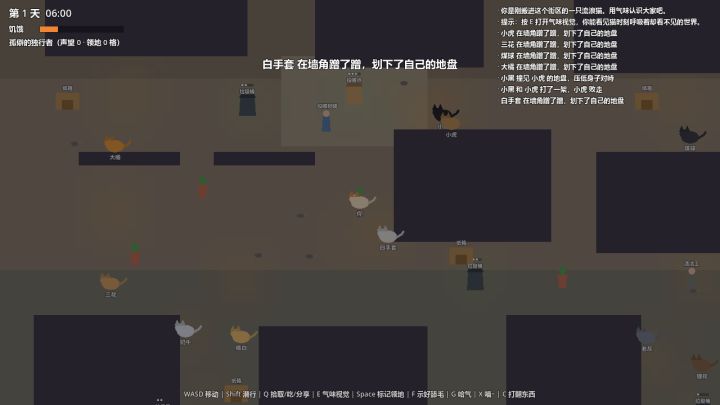
《气味之城》开发日志#1|为什么"涌现"和猫是天作之合
大家好,我是一个人报名了 2026 聚光灯 21 天游戏创作挑战 的独立开发者。今年主题公布那一刻我就笑出了声——涌现。因为我已经想做这个游戏很久了:
《气味之城》:你不是猫神,你只是一只猫。
先说一个所有养猫人都懂的事实:你永远无法"教会"一只猫任何它自己不想学会的事。但你家猫可能自己学会了——听见冰箱开门就瞬移到厨房;你心情不好时过来踩奶;凌晨三点准时在你身上练马拉松。没人教过它,这些行为是它
@体验人生
3 赞
2 回复
开发日志04:事件池和文案的打磨
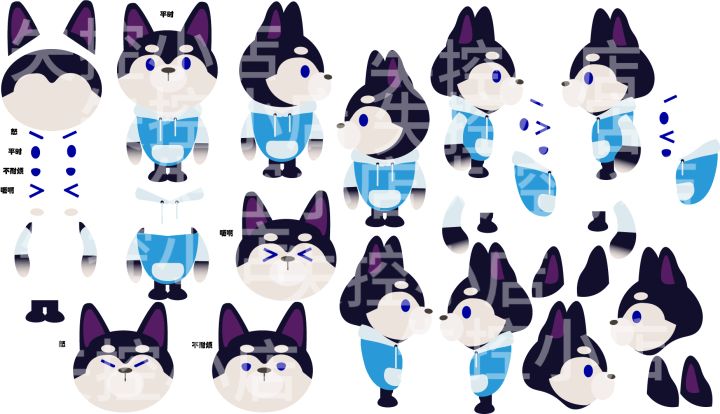
事件池目前填了十多条,从黑帮讨债、浣熊偷吃被发现,到检查员上门、网红探店、黑帮老大视察。测试时发现有些事件触发太频繁,比如“客人起冲突”在店里稍微挤一点就蹦出来,玩起来很烦。于是调低了基础权重,加了冷却。
顾客台词也在改。之前写了一些偏人类视角的句子,比如“你们疯了吗”“这座城市”,后来全部删掉,换成动物世界的说法。客人本身也是动物,抱怨的是另一只动物在偷吃、在开店,这样才对味。
直播间弹幕也做了
@雾凇
2 赞
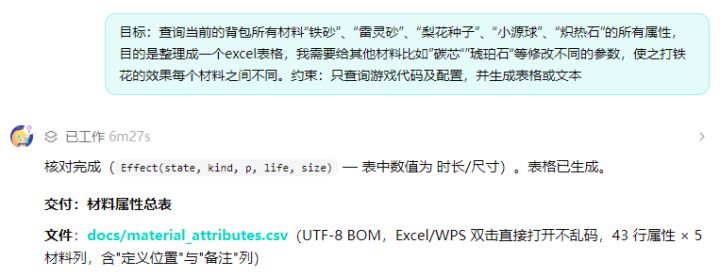
《世界第一的铁花匠》开发者日志#04—如何控制AI制造生成的游戏
(捏一把vv的小脸)Hi大家好,我又来了,我是caaat工作室的唯一人类成员,看看!
今天继续给大家分享我用taptapmaker的vibecoding制作游戏的心得,本次分享的其实是个反vibecoding的部分,说直白点就是作为一个N年策划,我今天突然想给自己的AI制作游戏配表了[心动小镇_震惊][心动小镇_震惊][心动小镇_震惊],然后发现,诶,表呢,我的表在哪里?(大误🌫)
首先说一个大前
@caaat
1 赞
1 回复