
下载 App
《忆如泉涌》开发日志 #06:第一阶段收官——五个玩法、五种涌现
10/213 浏览


这是第一阶段开发日志的最后一篇。
前五篇各讲了一种涌现的形态。这一篇把它们收在一起,交代第一阶段做完了什么、还剩什么没做,以及为什么这五个玩法值得放在同一个游戏里。
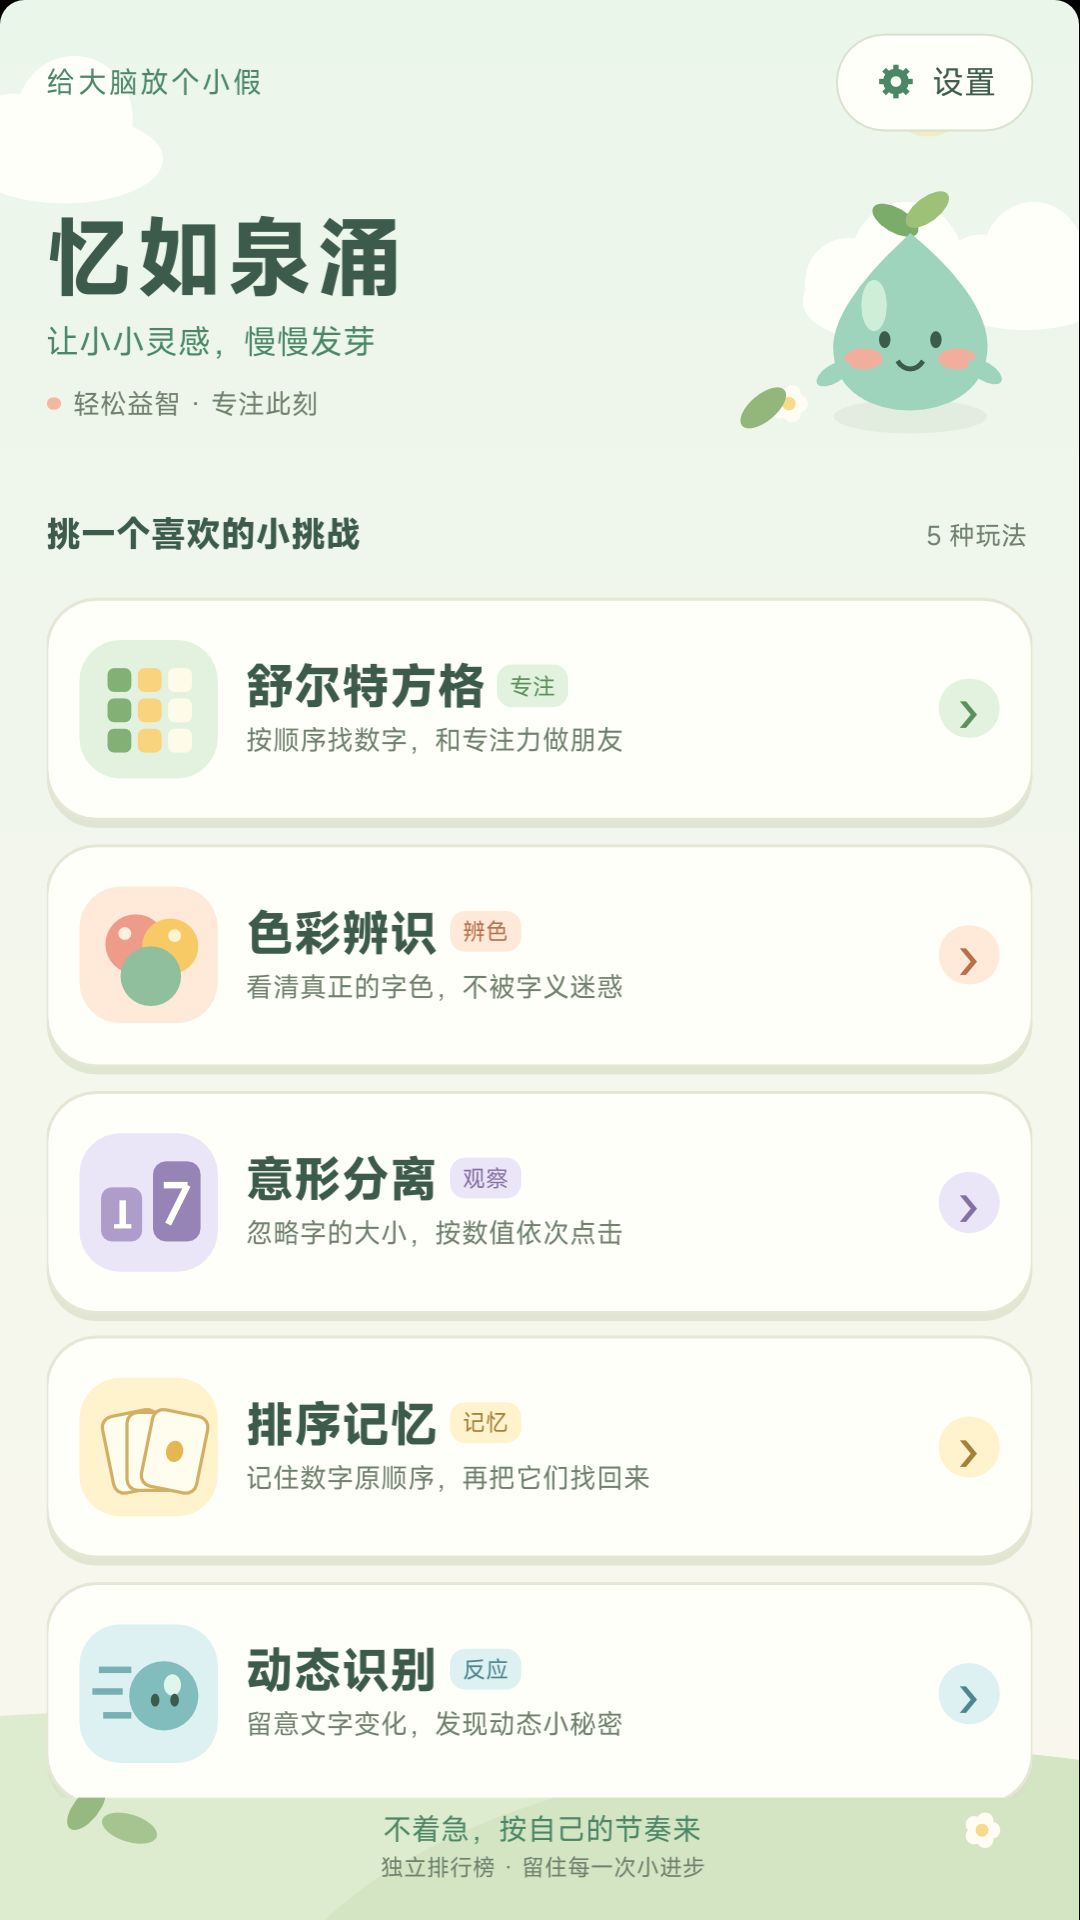
先看现在的主界面。
五个玩法入口,一个水滴角色,奶油色小花园。这是用引擎的程序化绘制画出来的,没有加载任何贴图。
一、五个玩法,五种涌现
把五个玩法并排看,它们其实是同一件事的五种做法:
| 玩法 | 干扰是什么 | 涌现从哪来 | 一句话规则 |
|---|---|---|---|
| 舒尔特方格 | — | 难度的随机分布 | 按 1 到最大数依次点击 |
| 色彩辨识 | 字义 | 语义与视觉冲突 | 看字色,不看字义 |
| 意形分离 | 字号 | 数值与字号绑定 | 忽略大小,按数值升序 |
| 排序记忆 | 时间 | 信息随时间衰减 | 记住顺序,再复现出来 |
| 动态识别 | 运动 | 干扰本身在运动 | 忽略字义,看它怎么动 |
它们共享同一个设计原则:只给规则,不给答案。
五个玩法加起来,代码里没有一处"关卡设计"——没有手工摆的题、没有预设的难度曲线、没有写死的关卡顺序。全部是:
规则 + 随机 → 涌现
五种干扰的性质其实不一样
再细看"干扰"这一列,会发现它们作用在不同的认知层:
| 玩法 | 干扰作用在 | 你需要压住什么 |
|---|---|---|
| 色彩辨识 | 语义层 | 读到的意思 |
| 意形分离 | 知觉层 | 看起来的大小 |
| 排序记忆 | 记忆层 | 信息的流失 |
| 动态识别 | 时间层 | 错过就没有 |
同一个结构,长在四个不同的认知层级上。 这是我在做这五个玩法时最满意的一点——它们不是"五个小游戏",而是同一个问题的五种问法。
二、第一阶段的完整成果
玩法
| 项 | 状态 |
|---|---|
| 五个主要玩法 | ✅ 全部实装 |
| 独立排行榜(每玩法分开建榜) | ✅ |
| 本地存档 + 离线补交 | ✅ |
| 五玩法独立的最佳成绩曲线 | ✅ |
音频
第一阶段末段把听觉补上了。这是之前一直欠的债——游戏一直是哑的。
音频设计先定了一条硬原则:不抢注意力。
舒尔特方格的胜负来自视觉搜索,如果 BGM 太抢耳,反而干扰玩家。所以:
| 通道 | 音量 | 说明 |
|---|---|---|
| BGM | 0.20(≈ −14 dB) | 压到音效的约 1/3,只提供氛围 |
| SFX | 0.65(≈ −3.7 dB) | 点击反馈必须清晰可辨 |
而且做了频率分工:1–4 kHz 这个区间留给音效,BGM 在这里不做持续长音。因为点击音效是玩法的核心反馈,不能被音乐盖住。
BGM 初版用 0.32,实听后偏高,统一降到 0.20。 这种"听起来还行"和"实听偏高"的差距,只能靠真的去听。
音效还有个设计:正确点击的音高会随进度上行(五声音阶逐级升高)。点得越多,音越高——进度不只是屏幕上的数字,也是耳朵能听到的上升感。
主界面
主界面重做成了奶油色小花园主题。水滴角色、五个玩法卡片、程序化绘制的云和叶子。
整个主界面没有一张贴图——全部是 NanoVG 程序化绘制。这样做的原因是:贴图要加载、要打包、要适配各种分辨率;而程序化绘制在任何分辨率下都是清晰的,也不会增加包体。
三、测试:第一阶段的总账
第一阶段结束时,跑完全部验证:
| 验证项 | 断言数 | 结果 |
|---|---|---|
| 舒尔特方格(含音效、BGM) | 5937 | ✅ |
| 意形分离 | 3509 | ✅ |
| 排序记忆 | 967 | ✅ |
| 主界面 / 花园 | 438 | ✅ |
| 色彩辨识 | 286 | ✅ |
| 动态识别 | 177 | ✅ |
| 菜单 | 65 | ✅ |
| 动态识别屏幕 | 49 | ✅ |
| 排序记忆屏幕 | 25 | ✅ |
| 反馈屏幕 | 5 | ✅ |
| 合计 | 11458 | 全部通过 |
11458 项断言,零失败。
这些断言覆盖的不只是"功能对不对",还包括:
- 时间边界:9.999 / 10.000 / 10.001 秒的精确判定;
- 输入防护:多指、长按、跨题松开、触摸派生鼠标事件;
- 异常路径:到点时正在展示、事件先于帧更新到达、后台中断;
- 布局:多种分辨率、安全区、高缩放下的溢出检查;
- 音频:淡入淡出时序、切后台立即停止、页面重建不重启。
四、这一阶段,测试抓到的 bug
回头看,第一阶段测试抓到的问题,比我想象的多。而且大部分不是玩法逻辑错,是别的地方错:
| 阶段 | 抓到的问题 | 性质 |
|---|---|---|
| #03 | 单格尺寸求解器迭代预算不够 → 棋盘溢出 | 产品代码 bug |
| #03 | 倒数卡在 3(页面重建重置了局部变量) | 产品代码 bug |
| #04 | 字号过大导致部分设备题面空白 | 产品代码 bug |
| #05 | 测试推进节奏错(每两轮才答一次题) | 测试代码 bug |
| #05 | 答错选项写死,可能碰巧答对 | 测试代码 bug |
| #05 | mock 数据排反了 | 测试代码 bug |
| #06 | p:sub(1, 11) 应为 p:sub(1, 10) | 测试代码 bug |
| #06 | 替身不记录失败调用,断言计数对不上 | 测试代码 bug |
八项里有一半是测试自己的错。
这让我对"测试"这件事有了更实际的认识:
- 测试代码也是代码,一样会错。 而且测试写错了更隐蔽——因为你会先怀疑产品代码。
- 测试要模拟真实行为,不是理想行为。 玩家不会每 1 秒精确点一次,不会故意选一个可能碰巧正确的选项。
- 同一逻辑要有独立验证。 动态识别那两个测试脚本,一个用正确写法、一个用错误写法——正是"两份独立实现"让差异暴露了出来。
最后一项尤其重要:如果只有一个测试,那个错误写法会一直"通过"下去。
五、下一阶段
第二阶段要做的,按优先级:
- 真实设备验收 —— 补上最大的空白。真机跑一遍,触摸、后台、联网、性能;
- 意形分离容量极限 —— 实测出到底能撑到第几组,而不是理论上算;
- 真实账号联网榜单 —— 从接口替身换到真实 TapTap 账号;
- 发布物料上传 —— 打通平台上传通道。
六、一点感想
第一阶段从一份策划案开始,到五个能玩的玩法、11458 项通过断言结束。
如果只能总结一句话,我想说的是:做涌现,最难的不是"设计",是"忍住不设计"。
- 忍不住想给每关配难度 → 那随机就白做了;
- 忍不住想把冲突题全挑出来 → 那玩家就学会套公式了;
- 忍不住想帮玩家逐位标出错误 → 那记忆玩法就废了;
- 忍不住想调大迭代预算让 bug “消失” → 那根因就永远埋着。
每一次"忍住",换来的都是规则自己长出东西的空间。
五个玩法,五条不同的路,但走的是同一件事:
给规则,不给答案。
本文为《忆如泉涌》开发日志第 6 篇,也是第一阶段收官,记录 2026-10-21 的音频、主界面与全量回归验证。
00:07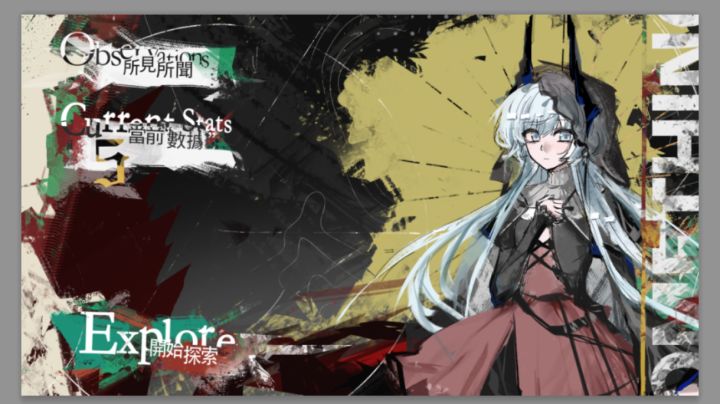
雨天決行 开发者日志02-人工智能的自我修养
又和大家见面啦!第二篇日志,说实话一开始不知道该怎么编排,但团队里惊喜的成果越来越多,我们已经迫不及待把更新的内容端上来给大家啦!那么事不宜迟,快来看看都有什么新情报吧ദ്ദി˶ー̀֊ー́ )✧
一.美术(重磅升级)
以主美小为的生命力作为燃料(bushi)本次美术组取得了大进程!首先是各个ui界面的优化和细化,上次大家看到时还只是初具雏形的草稿,现在大多都完整起来了哦!
同时,随着配色的补全,手
@雨天決行-床子酱(๑>ڡ<)☆
43 赞
36 回复
【童谣镇】聚光灯第二次开发日志
开发进度:
美术
1、主角人物立绘已细化完成
2、所有NPC的QQ人形象与呼吸动画已设计完成
3、大部分UI界面已设计完成
4、面包房建模与树屋建模以及基础房屋、路灯、树木模型已完成。
5、制作过场动效,制作通用动效材质ing
6、广场资产替换、永续桥和植被的资产替换、房屋资产替换,河流制作
7、学校模型的材质完成
8、石墩子、小道具模型制作ing
9、NPC正比胸像绘制ing
策划
1、任务系统
@奈奈
11 赞
10 回复
00:34
《荒原复苏指南》开发日志④:关卡演示堂堂袭来!!
- 人类曾因掌握元素合成技术而一度辉煌,又因滥用元素能量而逐渐从内里衰败。
- 30世纪80年代。社会文化充斥着激进乐观主义与庞大机械美学,在这里,污染和能源共生,幸福与痛苦并存。官方广播和宣传画里依旧在宣扬“科学将战胜一切”、“元素能量将再造新农田”的口号,而世界主城却已经因为污染过度而濒临崩溃、空间挤压严重。为了寻找新的生存空间与无污染能源,官方启动了“重构拓荒计划”。
- 玩家将作为前线拓展
@归尘www
18 赞
6 回复
《卡牌工业》开发日志 01|从“涌现”到产线对打
大家好,我们正在用 Godot 做一个暂名《卡牌工业》的游戏。目前已经跑通了最小的生产与战斗循环,也做了两轮迭代。这篇先记录一下:面对“涌现”这个题目,我们讨论过什么,又为什么最后收敛到卡牌和工厂。
第一步:头脑风暴,涌现可以是什么?
刚看到“涌现”这个题目时,我们的想法几乎朝每个方向散开了。塔防、物理搭建、探索、解谜、经济系统、叙事,甚至增量游戏,都能让简单规则在玩家的操作中长出新的结果。再想下
@泛滥
1 回复
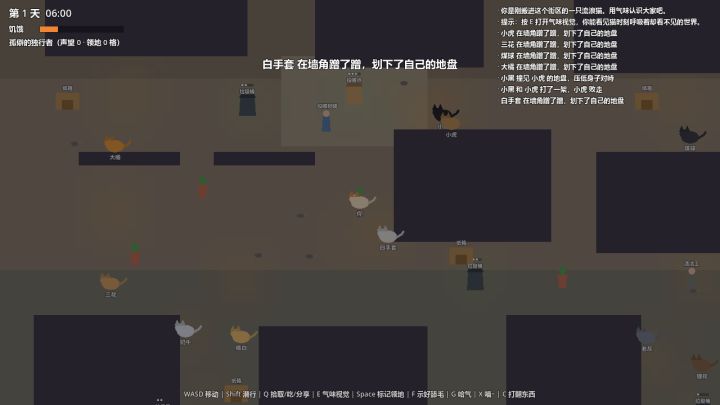
《气味之城》开发日志#1|为什么"涌现"和猫是天作之合
大家好,我是一个人报名了 2026 聚光灯 21 天游戏创作挑战 的独立开发者。今年主题公布那一刻我就笑出了声——涌现。因为我已经想做这个游戏很久了:
《气味之城》:你不是猫神,你只是一只猫。
先说一个所有养猫人都懂的事实:你永远无法"教会"一只猫任何它自己不想学会的事。但你家猫可能自己学会了——听见冰箱开门就瞬移到厨房;你心情不好时过来踩奶;凌晨三点准时在你身上练马拉松。没人教过它,这些行为是它
@体验人生
3 赞
6 回复
00:30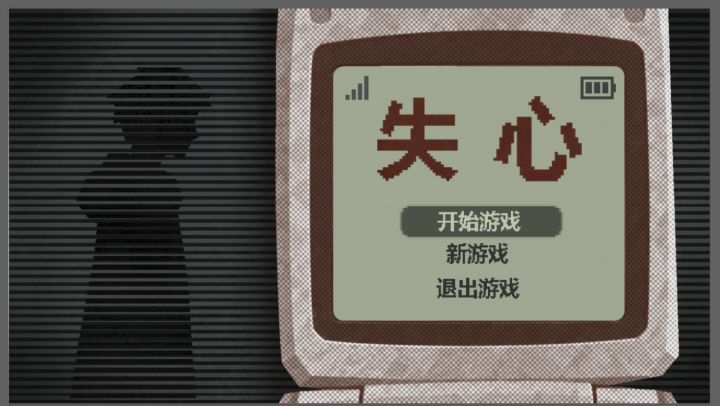
《失心》游戏开发者日志01|游戏UI迭代及实机演示
进入《失心》之前,玩家首先看到的是我们工作室 UNLOOK 的标识。我们将原来的标识转成 SVG,并让其中的红色瞳点转动、观察,再逐步显露完整字形,希望这个短暂的开场能带出一点好奇和不安。
这次《失心》的开局 UI,我们围绕小灵通(因为游戏的主要交互道具就是小灵通)做了几轮调整,希望玩家从打开游戏开始,就能感受到故事里的年代和气氛(故事年代背景为2000s)。
早期版本先确定了一个方向:把菜单放进
@Chye
15 赞
10 回复
【2026聚光灯日志01】什么叫你把手牌,骰子和战棋融合了?
大家好啊,我是官方小编,一位还在学校的独自开发的苦逼带学生
这次算是第二次正式参加GameJam,而这回的比赛主题是【涌现】
嗯…老实说,一开始我还真只是从中文语义上来看,理解成“大量的出现”,直到询问ai哦哦哦我这就才想起来还有英文的“整体大于部分之和”意思来着
说起这个主题的意思,立马想起的类 吸血鬼幸存者 ,或者是 文明 系列的各种爆怪,爆兵的设计,即大量的出现敌人或者单位
而从第二个
@官方小编
4 赞
4 回复
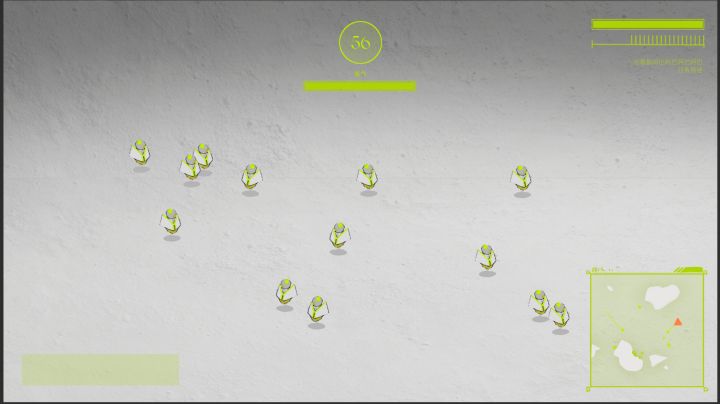
开发者日志#01:涌现!! 披着科幻外衣的涌现式增量游戏!!!!
随着Game Jam 主题公示,我们团队立马着手维持了三天的激烈讨论!决定做一个披着科幻外衣的蚂蚁农场以boids算法为灵感的涌现式增量游戏!!!
至此,方案敲定,我们团队将开发一个可升级的自主群体模拟,并且初步规划了玩家游戏时的体验流程:
(1)阶段1(开局30s,触发痛点,会有一次提升,但是游戏仍然艰难):一张地图分布着资源点和仓库,玩家此时只能徒手采集资源点的矿石拖入仓库,矿石可以造机器人;
@孤单小🐟
14 赞
7 回复
【开发者日志 #01】从玩游戏到做游戏:我们用记忆诠释「涌现」
大家好呀,我们是【肝完就是胜利】组合!
最开始我们只是刷刷作品、玩玩游戏。万万没想到,现在居然能和一群三观契合、热爱创作的小伙伴一起,从“玩游戏的人”,变成了“做游戏的人”。在TapTap打磨属于我们自己的作品,真的是一件奇妙又幸运的事。
Gamejam【涌现】主题公布后,我们几个人陷入沉思。
好抽象!好哲学!我们反复挠头:玩家能看到什么?感受到什么?又能在游戏里收获什么全新的体验?让我们一时无从
@Yuri
5 赞
4 回复
00:10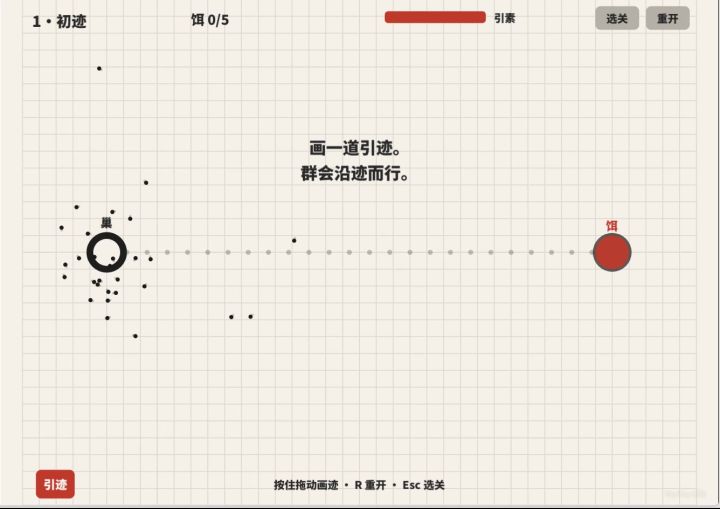
群迹·上取其下,下取其上
#聚光灯gamejam开发者日志
向大家汇报一下今日进度,目前在和蚁群的默认移动算法进行斗智斗勇。或许是我的AI对蚂蚁有别样的理解,其实最初写出的方案更接近于围绕着恒星公转的行星。
哦我还以为文章里可以插入多支视频视频,想要展示一些其它的运动方式,可惜了。那么就简单在上方传一个比较典型的,有点类似于蟑螂的运行方式。
目前仍在解决蚁群的随机运动,和玩家可操纵性之间的平衡问题。以及如各位所见,目前的
@孤叶 带寒
4 赞
1 回复